Nền tảng marketing AI: bản thiết kế dữ liệu từ WPP
Cách xương sống dữ liệu có quản trị của WPP biến pilot AI rời rạc thành phân tích tin cậy, nhắm mục tiêu dự đoán và marketing tạo sinh ở quy mô doanh nghiệp.
Tổng quan
Một nền tảng tiếp thị AI chỉ có thể đạt cấp độ vận hành sản xuất thực tế khi các nhà lãnh đạo tiếp thị, MarTech, tăng trưởng, RevOps và nền tảng dữ liệu cung cấp cho các mô hình một khung dữ liệu dùng chung có quản trị chặt chẽ. Dữ liệu khách hàng phân tán khiến các dự án thử nghiệm trở nên chậm chạp, thủ công và cô lập; mỗi trường hợp sử dụng trở thành một nỗ lực riêng lẻ. Vanaxity, tác nhân nội dung tự chủ của Van Data Team, áp dụng chính kỷ luật đó thông qua nghiên cứu, biên soạn, minh họa, xuất bản và phân phối cho SEO, GEO và AEO. Cẩm nang này chuyển hóa thiết kế trên Google Cloud của tập đoàn WPP thành một kiến trúc trung lập với nhà cung cấp, khung tiếp nhận thực tiễn và danh mục kiểm tra mức độ sẵn sàng.
Những điểm cốt lõi cần nắm vững
Tiếp thị AI ở cấp độ sản xuất phụ thuộc vào một hệ thống dữ liệu có thể tái sử dụng với các cơ chế kiểm soát có thể thực thi, không phải một tập hợp các bản demo mô hình rời rạc.
- Mô hình được ghi nhận của WPP kết hợp các dự án dữ liệu dùng chung, hạ tầng điện toán xử lý tách biệt, định nghĩa đối tượng chuẩn hóa và các đường ống dữ liệu được điều phối nhịp nhàng.
- Tập trung hóa việc nhận diện danh tính, trạng thái đồng ý, nguồn gốc dữ liệu và các quy tắc phân nhóm chung. Cho phép các đội ngũ nghiệp vụ sở hữu các sản phẩm dữ liệu giàu ngữ cảnh theo các tiêu chuẩn chung.
- Đo lường độ mới của dữ liệu, độ tin cậy của đường ống, tính an toàn khi thử lại, nguồn gốc, chi phí và mức độ tuân thủ cam kết dịch vụ (SLA) trước khi ca ngợi hiệu suất của mô hình.
- Bổ sung hệ thống phân tích có quản trị trước tiên, nhắm mục tiêu dự đoán tiếp theo, và chỉ kích hoạt quy trình tạo sinh sau khi các cơ chế đánh giá và an toàn đã hoạt động ổn định.
- Lựa chọn nền tảng dữ liệu khách hàng (CDP), kiến trúc thuần kho dữ liệu (warehouse-native), hoặc mô hình lai (hybrid) dựa trên khối lượng công việc thực tế, không dựa vào nhãn danh mục tiếp thị.
Trước khi mua thêm một công cụ AI khác, hãy sử dụng quy trình có quản trị của Vanaxity để yêu cầu đánh giá miễn phí nội dung và quy trình làm việc. Kết quả bàn giao bao gồm bản đồ nguồn dữ liệu, đánh giá cổng kiểm duyệt, các lỗ hổng trên bảng điều khiển và kế hoạch triển khai cụ thể theo phạm vi.
Xác định quy trình SEO, GEO và AEO phù hợp trước khi triển khai.
Tại sao các dự án thử nghiệm tiếp thị AI lại đình trệ trước khi vào sản xuất?
Các dự án thử nghiệm tiếp thị AI bị đình trệ vì dữ liệu phân mảnh buộc từng trường hợp sử dụng phải tái tạo lại dữ liệu đầu vào, logic đối tượng, phân quyền và các bước phê duyệt từ đầu.
Chẩn đoán này là phân tích chuyên môn từ Vanaxity, không phải kết luận về mọi chương trình của WPP. Một bản demo chiến dịch có thể tồn tại dựa trên các tệp dữ liệu sao chép thủ công và các bước kiểm tra bằng tay. Một hệ thống vận hành sản xuất thì không thể như vậy. Một khi nhiều đội ngũ áp dụng các quy tắc nhận diện hoặc logic đồng ý dữ liệu khác nhau, không có mô hình nào có được một ngữ cảnh hoạt động ổn định. Bổ sung thêm một mô hình hoặc công cụ kích hoạt chỉ làm tăng thêm một điểm phụ thuộc phức tạp.
Sai lầm mà chúng tôi thường thấy tại Van Data Team là bắt đầu từ những sản phẩm hiển thị bề nổi: các đội ngũ chọn một mô hình AI, kết nối một tập dữ liệu mẫu và tối ưu hóa một chiến dịch. Họ chưa từng thống nhất về việc ai sở hữu nguồn dữ liệu, dữ liệu phải mới đến mức nào, hoặc định nghĩa đối tượng nào mới mang tính thẩm quyền. Thành công vì thế bị mắc kẹt bên trong phạm vi thử nghiệm hạn hẹp.
Hãy xem xét một ví dụ minh họa về đợt triển khai khu vực: một trưởng nhóm tăng trưởng yêu cầu tạo nhóm đối tượng 'khách hàng giá trị cao'. Bộ phận thương mại dựa trên mức chi tiêu gần đây, bộ phận CRM dựa trên phân hạng tài khoản, và bộ phận truyền thông dựa trên mức độ tương tác. Từng mô hình đều chạy, nhưng kết quả đầu ra lại mâu thuẫn lẫn nhau. Một định nghĩa nhóm chuẩn hóa, được sở hữu và quản lý phiên bản một lần duy nhất, sẽ giúp đối tượng có thể tái sử dụng lâu dài, đồng thời làm lộ rõ sự bất đồng trước khi kích hoạt chiến dịch.
Giải pháp khắc phục thực tế là một nền tảng dữ liệu tiếp thị có quản trị. Nền tảng này cần cung cấp dữ liệu khách hàng và chiến dịch dùng chung, logic chuyển đổi tái sử dụng được, và các cổng phát hành rõ ràng. Khi đó, các mô hình sẽ tiếp nhận những sản phẩm dữ liệu đã được phê duyệt thay vì tự tạo ra sự thật cục bộ của riêng mình.
Những gì WPP đã xây dựng: Khung xương sống của nền tảng tiếp thị AI
WPP đã xây dựng một khung dữ liệu dùng chung giúp tách biệt tầng lưu trữ có quản trị khỏi tầng xử lý tính toán, chuẩn hóa các nhóm đối tượng và cung cấp dữ liệu cho các tác vụ phân tích và AI.
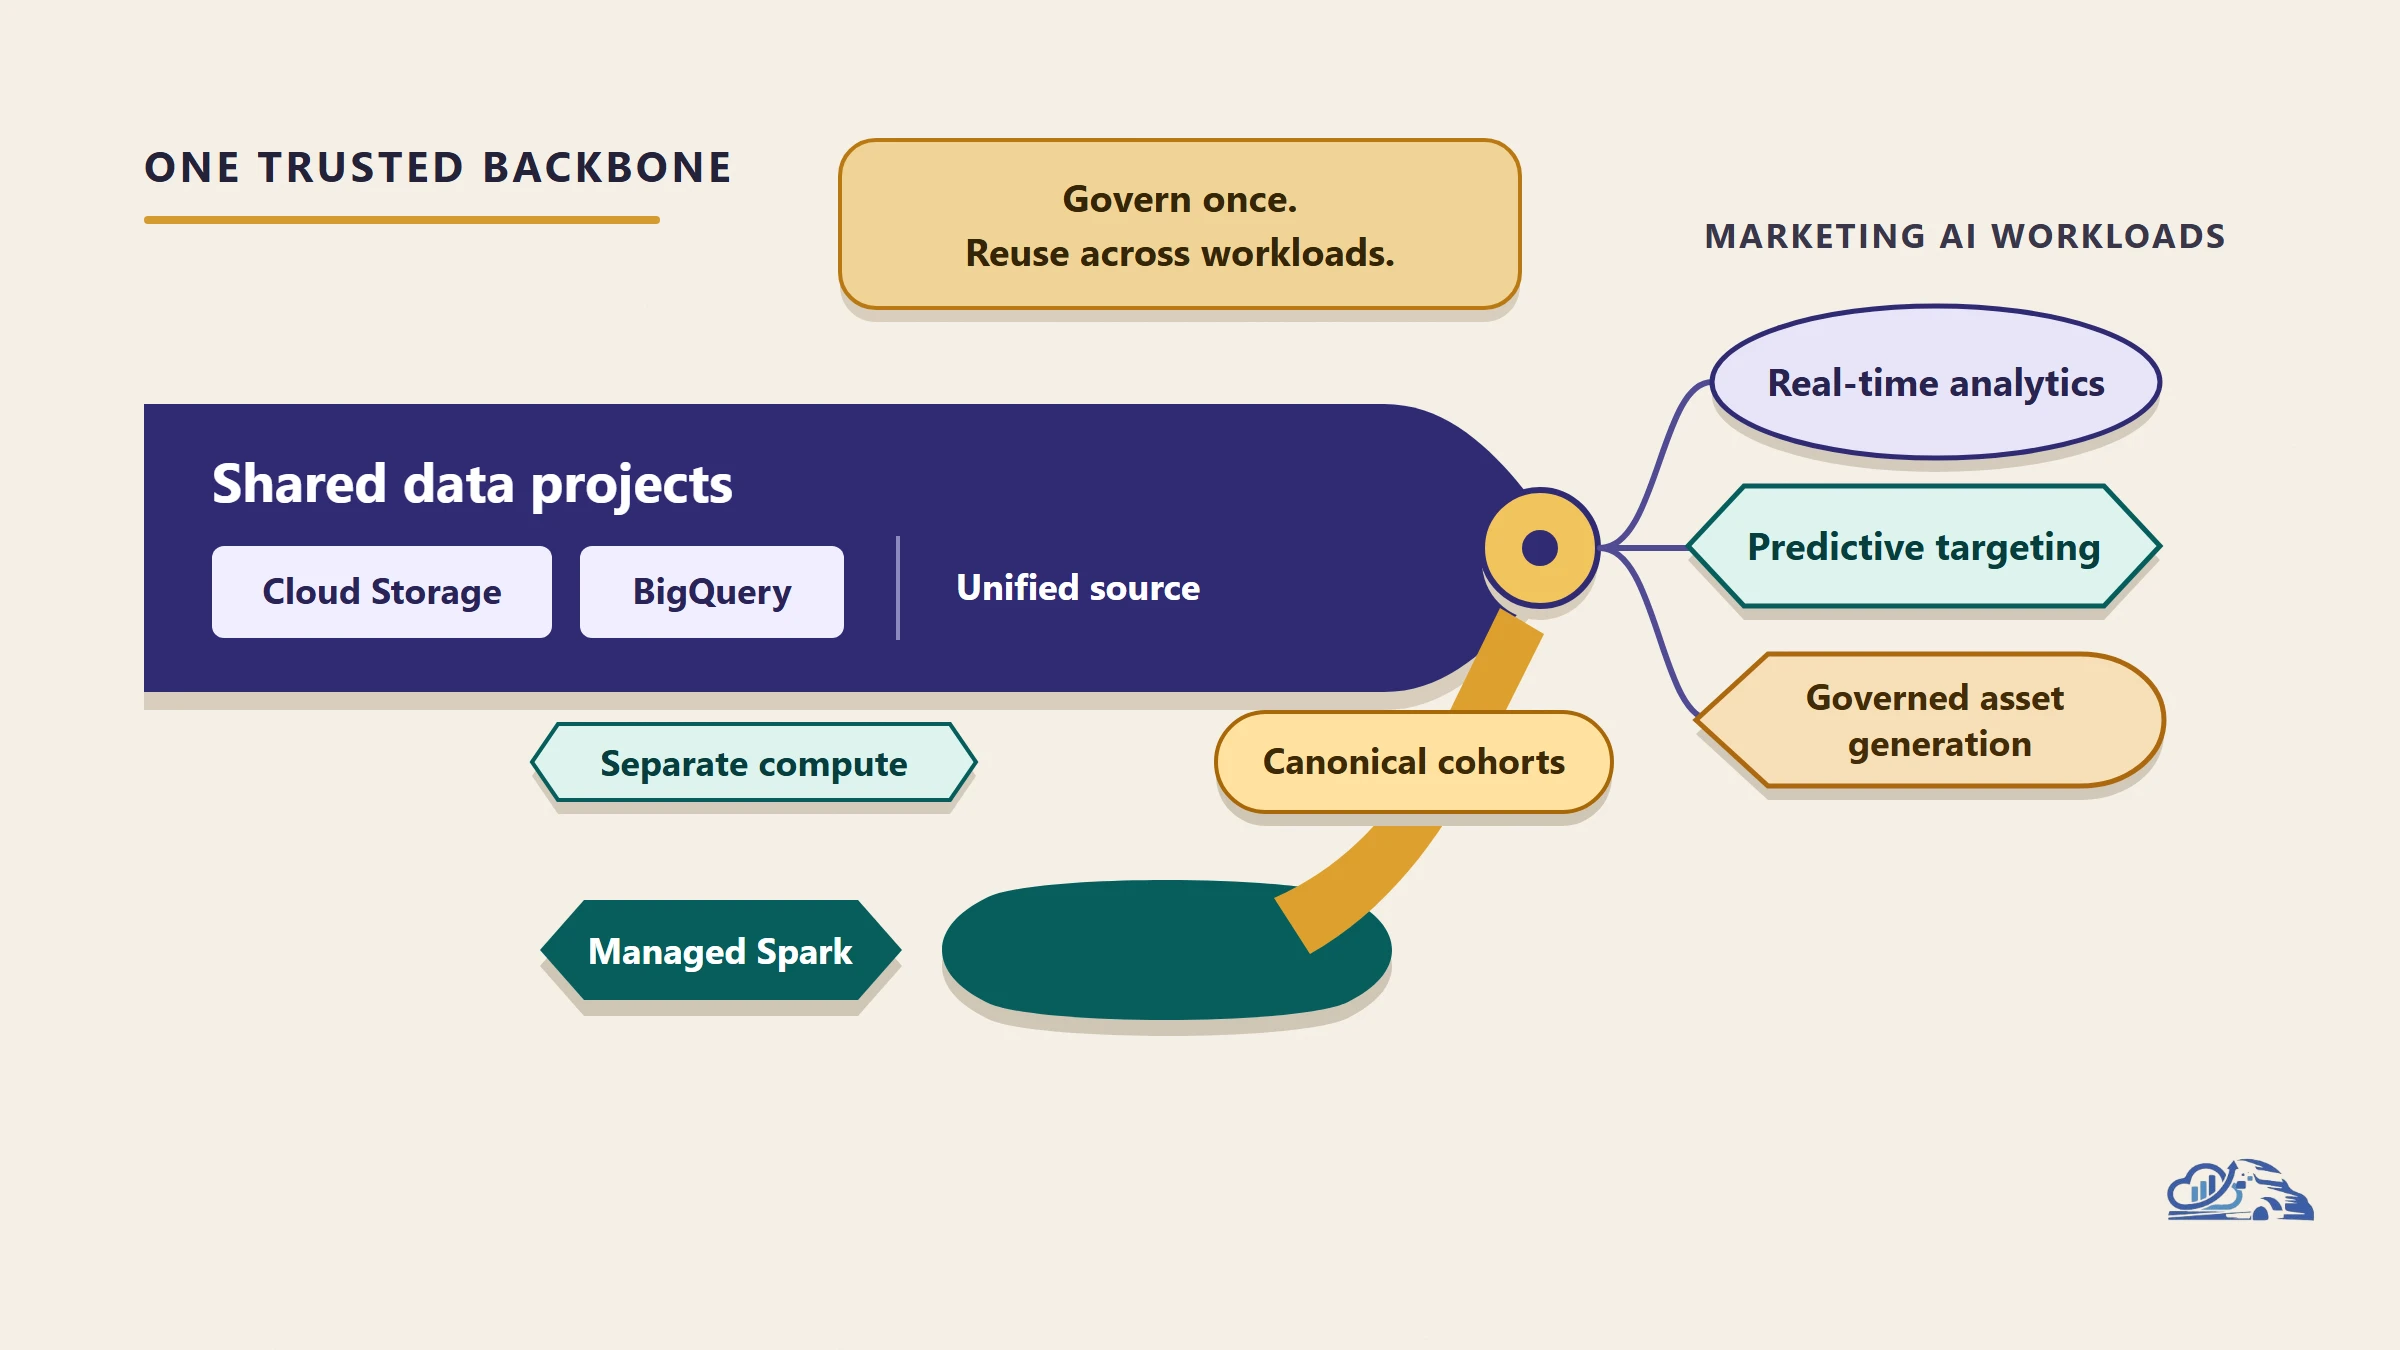
Vào ngày 10 tháng 8 năm 2026, Google Cloud công bố nghiên cứu điển hình về WPP, mô tả WPP như một tập đoàn quảng cáo và tiếp thị toàn cầu. WPP tập trung hóa Google Cloud Storage và BigQuery trong các dự án dữ liệu dùng chung, đồng thời đặt tài nguyên điện toán trong các dự án xử lý riêng biệt, mang lại cho các bên tiêu thụ một nguồn sự thật duy nhất.
Cũng theo nghiên cứu điển hình này, Managed Service for Apache Spark chạy các tác vụ Scala và Spark để làm sạch, chuẩn hóa và định hình dữ liệu chính thống. Các tác vụ đó tạo ra những định nghĩa nhóm đối tượng chuẩn mực. Kubeflow cung cấp khả năng điều phối đường ống không máy chủ. Dữ liệu đáng tin cậy sau đó hỗ trợ các khối lượng công việc trên BigQuery và Vertex AI phục vụ phân tích tiếp thị thời gian thực, nhắm mục tiêu dự đoán và tạo sinh tài sản thương hiệu tùy chỉnh.
Hệ sinh thái rộng lớn hơn còn mở rộng ra ngoài phạm vi nghiên cứu đó: trang đối tác Google của WPP liệt kê BigQuery, Looker, Spanner, Open Intelligence, InfoSum Bunkers, quyền truy cập DeepMind, Gemini, Imagen và Veo, định vị InfoSum như một lớp cộng tác dữ liệu ưu tiên quyền riêng tư. Bài viết của BigDataWire về WPP Open mô tả WPP Open như một nền tảng tiếp thị tác nhân hỗ trợ phân tích, lập mô hình đối tượng và quy trình tạo sinh.
Nghiên cứu điển hình chính đúc kết mục tiêu của dữ liệu dùng chung thành một cụm từ đắt giá:
"một nguồn sự thật duy nhất"
Phân tích của Vanaxity bắt đầu từ điểm kết thúc của kiến trúc được ghi nhận: bài học có thể chuyển giao không phải là mọi doanh nghiệp đều phải sao chép y nguyên các dịch vụ Google Cloud của WPP. Dữ liệu dùng chung và điện toán tách biệt mới là mô hình bền vững lâu dài. Sự phân tách này giúp cải thiện khả năng tái sử dụng, cô lập khối lượng công việc, kiểm soát truy cập và quy kết chi phí minh bạch. Các sản phẩm công nghệ cụ thể nên dựa trên nhu cầu công việc, kỹ năng sẵn có và các lựa chọn dịch vụ hiện tại. Hãy kiểm tra tên gọi và tính năng trên tài liệu chính thức của Google Cloud trước khi triển khai.
Nên tập trung hóa hay liên kết hóa nền tảng tiếp thị AI?
Hãy tập trung hóa các định nghĩa và cơ chế kiểm soát dùng chung, nhưng liên kết hóa quyền sở hữu ở những nơi bối cảnh nghiệp vụ làm thay đổi ý nghĩa của dữ liệu.
Mô hình data mesh là một phương thức vận hành trong đó các miền nghiệp vụ sở hữu các sản phẩm dữ liệu có thể tái sử dụng theo các tiêu chuẩn quản trị và chất lượng chung. Đó không phải là một sản phẩm phần mềm bắt buộc hay một thiết kế mạng cứng nhắc. Các đội ngũ tiếp thị, thương mại, bán hàng và khu vực có thể duy trì chuyên môn sâu của mình mà không tạo ra các phiên bản sự thật mâu thuẫn nhau.
Hãy tập trung hóa việc hợp nhất danh tính, trạng thái đồng ý, các nhóm đối tượng chuẩn hóa, nguồn gốc dữ liệu, quy tắc truy cập và các thước đo chiến dịch chung. Liên kết hóa quyền sở hữu khi một miền nghiệp vụ phải duy trì ý nghĩa gốc hoặc chính sách bản địa. Nguyên tắc ra quyết định rất rõ ràng: tập trung hóa một sản phẩm dữ liệu khi nhiều đội ngũ cùng cần một định nghĩa và cơ chế kiểm soát giống nhau; liên kết hóa quyền sở hữu khi tri thức chuyên môn miền là bắt buộc, đồng thời thực thi nghiêm ngặt các hợp đồng dữ liệu dùng chung.
Bảng so sánh dưới đây là phân tích từ Vanaxity dựa trên mô hình nền tảng WPP đã được ghi nhận.
| Khía cạnh quyết định | Các dự án thử nghiệm riêng lẻ | Nền tảng dùng chung có quản trị |
|---|---|---|
| Truy cập dữ liệu | Mỗi trường hợp sử dụng tự sao chép dữ liệu nguồn | Các sản phẩm dữ liệu tái sử dụng cung cấp nguồn chung duy nhất |
| Tài nguyên điện toán | Gắn liền với từng mô hình và tập dữ liệu riêng biệt | Khối lượng công việc xử lý được tách biệt khỏi dữ liệu dùng chung |
| Logic đối tượng | Định nghĩa mâu thuẫn tùy theo từng đội ngũ | Định nghĩa nhóm chuẩn hóa được quản lý phiên bản và tái sử dụng |
| Vận hành đường ống | Tác vụ thủ công và lỗi phát sinh bị che giấu | Điều phối hỗ trợ giám sát, tự động thử lại và xử lý bù dữ liệu |
| Cơ chế quản trị | Chỉ được đánh giá sau khi sản phẩm đầu ra đã xuất hiện | Sự đồng ý, quyền truy cập và nguồn gốc được áp dụng ngay từ thiết kế |
| Ứng dụng AI | Các bản trình diễn tính năng cục bộ | Phân tích, nhắm mục tiêu và tạo sinh dùng chung các chốt kiểm soát |
| Quản lý chi phí | Khó quy kết theo từng khối lượng công việc cụ thể | Chi phí xử lý hiển thị minh bạch theo bên tiêu thụ hoặc tác vụ |
Thiết kế này không làm triệt tiêu quyền tự chủ của các đội ngũ bản địa; nó tạo ra một bản hợp đồng để việc tái sử dụng diễn ra an toàn. Các đội ngũ có thể tự do sáng tạo phía trên bản hợp đồng đó mà không phải tái thiết lập danh tính, sự đồng ý và logic đối tượng cho từng mô hình.
Những chốt kiểm soát chất lượng dữ liệu nào quan trọng trong sản xuất?
Độ mới của dữ liệu, nguồn gốc, tính an toàn khi thử lại, chi phí và mức độ tuân thủ cam kết dịch vụ (SLA) quyết định liệu AI tiếp thị có đáng tin cậy trong môi trường sản xuất thực tế hay không.
Đường ống dữ liệu là dòng chảy tự động giúp trích xuất, chuyển đổi và nạp dữ liệu (ETL), hoặc có thể trích xuất, nạp rồi mới chuyển đổi (ELT). Dù áp dụng mô hình nào, hệ thống cũng đòi hỏi các chốt kiểm soát có thể quan sát được:
- Độ mới và tính đầy đủ: xác nhận các nguồn dữ liệu bắt buộc đã cập bến đúng giờ và chứa đủ số lượng bản ghi kỳ vọng trước khi mô hình khởi chạy.
- Nguồn gốc dữ liệu (lineage): truy vết các bản ghi nguồn qua các bước chuyển đổi, đặc trưng (features), nhóm đối tượng, mô hình và các tài sản tạo sinh.
- Độ lệch lược đồ (schema drift): phát hiện khi một trường dữ liệu, kiểu dữ liệu hoặc cấu trúc nguồn thay đổi có thể phá vỡ logic xử lý phía sau.
- Thử lại an toàn và xử lý bù: đảm bảo các tác vụ thử lại mang tính bất biến (idempotent) để việc chạy lại không nhân đôi các hành động kích hoạt; quy trình xử lý bù (backfill) tái xử lý dữ liệu lịch sử chuẩn xác sau khi sửa lỗi hoặc thay đổi logic.
- Chi phí và cam kết dịch vụ (SLA): quy kết chi phí lưu trữ, điện toán, mô hình và ngân sách token theo từng khối lượng công việc; thỏa thuận SLA xác định rõ độ mới, tính sẵn sàng và thời gian phục hồi kỳ vọng.
- Sự đồng ý và an toàn thương hiệu: thực thi các mục đích sử dụng được phép trước khi nhắm mục tiêu; kiểm tra các tài sản tạo sinh đối chiếu với quy tắc thương hiệu trước khi xuất bản.
Khả năng quan sát dữ liệu tập trung vào việc đánh giá liệu dữ liệu đầu vào và các đường ống có vận hành lành mạnh hay không. Đánh giá mô hình và khả năng quan sát AI xem xét liệu hành vi dự đoán hoặc tạo sinh có duy trì được tính hữu ích, an toàn và nhất quán hay không. Các đội ngũ cần cả hai: một đường ống khỏe mạnh vẫn có thể nuôi dưỡng một mô hình yếu kém; ngược lại, điểm số mô hình cao không thể biện minh cho dữ liệu đầu vào cũ kỹ hoặc thiếu quản trị.
Hãy xem xét một sự cố giả định để minh họa: hệ thống CRM đổi tên một trường thông tin về sự đồng ý của khách hàng. Hợp đồng dữ liệu lập tức phát hiện độ lệch lược đồ và cách ly các bản ghi bị ảnh hưởng. Các kỹ sư sửa lại ánh xạ, chạy xử lý bù có kiểm soát và đánh giá lại các nhóm đối tượng trước khi tiếp tục kích hoạt chiến dịch. Quy trình đó biến quản trị thành một cơ chế kiểm soát vận hành thực thụ, như được mô tả trong cẩm nang quản trị tiếp thị AI của Vanaxity.
Chốt chặn phát hành cần được xác định rõ ràng: không kích hoạt một nhóm đối tượng hoặc xuất bản một tài sản tạo sinh trừ khi độ mới, sự đồng ý, nguồn gốc, chất lượng dữ liệu và các bước kiểm tra mô hình đều vượt qua thành công.
Các nhà lãnh đạo nên sắp xếp trình tự tiếp nhận như thế nào?
Các nhà lãnh đạo nên xây dựng dữ liệu đáng tin cậy và khung quản trị trước tiên, chứng minh hiệu quả phân tích tiếp theo, và chỉ bổ sung các khối lượng công việc dự đoán và tạo sinh theo các giai đoạn có kiểm soát.
Một trình tự tiếp nhận thực tế diễn ra như sau:
- Xác định mục tiêu và người chịu trách nhiệm: giao cho từng trường hợp sử dụng một chủ sở hữu kinh doanh, một chủ sở hữu kỹ thuật, tiêu chuẩn đầu ra được duyệt và thẩm quyền quyết định phát hành.
- Lập bản đồ nền tảng: kiểm kê các nguồn dữ liệu, quy tắc nhận diện danh tính, sự đồng ý, quy trình chuyển đổi, các đích đến và các điểm lỗi hiện có.
- Xuất bản các sản phẩm dữ liệu dùng chung: quản lý phiên bản cho các định nghĩa khách hàng, chiến dịch, nội dung và nhóm đối tượng mà nhiều đội ngũ có thể tái sử dụng.
- Thiết lập các cơ chế kiểm soát vận hành: bổ sung hợp đồng dữ liệu, truy vết nguồn gốc, kiểm thử chất lượng, cơ chế thử lại an toàn, quy trình xử lý bù, phân quyền truy cập, báo cáo chi phí và cam kết dịch vụ (SLA).
- Chứng minh hiệu quả phân tích có quản trị: sử dụng bảng điều khiển và phân tích thời gian thực để kiểm chứng xem cùng một dữ liệu có duy trì được độ tin cậy trên khắp các bên tiêu thụ hay không.
- Bổ sung nhắm mục tiêu dự đoán: chỉ đưa các mô hình vào vận hành khi độ tin cậy của dữ liệu đầu vào và các kiểm soát kích hoạt phía dưới duy trì được sự ổn định.
- Tích hợp các quy trình tạo sinh: kết nối các mô hình tạo sinh sau khi các cổng an toàn thương hiệu, đánh giá của con người, quy trình kiểm thử và cơ chế hoàn tác đã hoạt động thuần thục.
- Mở rộng thông qua tái sử dụng: chỉ mở rộng quy mô khi các trường hợp sử dụng mới có thể khai thác lại các thành phần có quản trị sẵn có thay vì sao chép thủ công.
Hãy đo lường độ tin cậy của dữ liệu trước khi ăn mừng chiến thắng của mô hình: theo dõi các lỗi độ mới, tỷ lệ thành công của đường ống, kết quả thử lại, độ phủ nguồn gốc, các khối chặn đồng ý, vi phạm SLA và chi phí theo từng tác vụ. Sau đó mới đo lường chất lượng dự đoán, chất lượng tài sản và tác động kinh doanh thực tế.
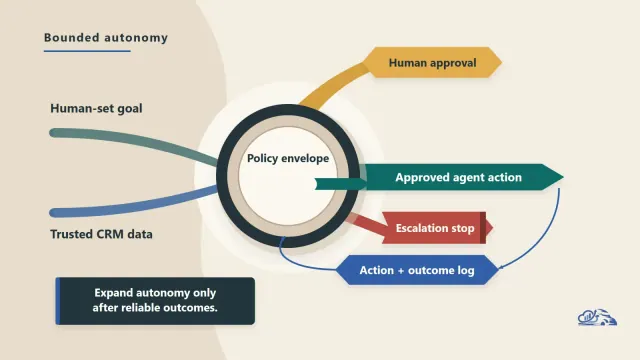
Tại Van Data Team, chúng tôi bắt đầu bằng việc lập bản đồ các tín hiệu, quyết định và cổng kiểm duyệt. Vanaxity áp dụng kỷ luật này để di chuyển mượt mà từ khâu nghiên cứu sang biên soạn, minh họa, xuất bản và phân phối. Cùng sự phân tách giữa ngữ cảnh tin cậy, thực thi của tác nhân, đánh giá chất lượng và phê duyệt của con người cũng định hình nên AI tác nhân hiệu quả trong tiếp thị.
Nên chọn CDP, kho dữ liệu thuần túy hay mô hình lai?
Hãy lựa chọn nền tảng dữ liệu khách hàng (CDP), kiến trúc thuần kho dữ liệu (warehouse-native), hoặc mô hình lai (hybrid) dựa trên tốc độ kích hoạt, độ sâu mô hình hóa, yêu cầu quản trị và quyền sở hữu vận hành thực tế.
Nền tảng dữ liệu khách hàng (CDP) là phần mềm hợp nhất dữ liệu khách hàng và hỗ trợ các nhà tiếp thị xây dựng cũng như kích hoạt các nhóm đối tượng. Giải pháp này phù hợp khi việc phân khúc do tiếp thị dẫn dắt và kích hoạt đa kênh là nhiệm vụ trọng tâm. Người mua vẫn cần kiểm tra kỹ khả năng nhận diện danh tính, quản lý sự đồng ý, tính linh hoạt của dữ liệu, độ trễ và cơ chế khôi phục khi có sự cố.
Kiến trúc thuần kho dữ liệu phù hợp khi các sản phẩm dữ liệu tái sử dụng, phân tích tùy biến chuyên sâu và các mô hình riêng biệt là động lực dẫn dắt chương trình. BigQuery là tầng kho dữ liệu được ghi nhận của WPP, nhưng mô hình này hoàn toàn trung lập với các nhà cung cấp. Hướng đi này mang lại sự linh hoạt kỹ thuật vượt trội, nhưng nó đòi hỏi năng lực kỹ thuật dữ liệu nội bộ vững vàng cùng các giao diện tự phục vụ rõ ràng.
Mô hình lai giữ kho dữ liệu làm nền tảng có quản trị vững chắc, trong khi CDP đảm nhiệm việc xây dựng và kích hoạt đối tượng. Nó có thể cân bằng giữa khả năng kiểm soát và tính tiện dụng, nhưng làm phát sinh thêm công việc đồng bộ, tích hợp và quản lý chi phí. Các đội ngũ phải xác định rõ hệ thống nào nắm quyền sở hữu từng định danh, trạng thái đồng ý, nhóm đối tượng và sự kiện kích hoạt.
Quyết định tự xây dựng hay mua sẵn cũng phụ thuộc vào khối lượng công việc cụ thể: so sánh nhu cầu về độ trễ, độ phức tạp của sự đồng ý, tính di động của dữ liệu, gánh nặng tích hợp, kỹ năng nội bộ, áp lực kiểm duyệt, các con đường phục hồi sự cố và tổng chi phí sở hữu (TCO). Hãy chọn kiến trúc nhỏ gọn nhất vừa đủ đáp ứng các yêu cầu về quản trị, tái sử dụng, độ trễ và chất lượng dịch vụ. Đừng để các nhãn danh mục tiếp thị chi phối quyết định của bạn.
Danh mục kiểm tra mức độ sẵn sàng của nền tảng tiếp thị AI
Một nền tảng chỉ thực sự sẵn sàng cho môi trường sản xuất khi các cơ chế kiểm soát về dữ liệu, mô hình, quản trị và khả năng phục hồi phối hợp chặt chẽ với nhau.
- [ ] Mọi trường hợp sử dụng đều có chủ sở hữu kinh doanh, chủ sở hữu kỹ thuật và tiêu chuẩn đầu ra xác định.
- [ ] Các hệ thống nguồn, quy tắc nhận diện danh tính và yêu cầu về sự đồng ý đều được văn bản hóa.
- [ ] Ranh giới giữa dữ liệu dùng chung và hạ tầng điện toán xử lý được phân định rõ ràng.
- [ ] Các định nghĩa khách hàng và nhóm đối tượng chuẩn hóa được quản lý phiên bản.
- [ ] Hợp đồng dữ liệu nêu rõ lược đồ, người sở hữu, quy tắc chất lượng, mục tiêu độ mới và cam kết SLA.
- [ ] Hiện tượng lệch lược đồ kích hoạt cảnh báo hoặc cách ly dữ liệu trước khi nạp vào mô hình.
- [ ] Logic thử lại đảm bảo tính an toàn và không làm nhân đôi các hành động kích hoạt hay sản phẩm đầu ra.
- [ ] Quy trình xử lý bù tái hiện chuẩn xác logic nhóm và chuyển đổi đã được phê duyệt.
- [ ] Nguồn gốc dữ liệu liên kết rõ ràng từ bản ghi nguồn đến các đặc trưng, mô hình, đối tượng và tài sản.
- [ ] Kiểm soát truy cập giới hạn việc sử dụng dữ liệu và mô hình theo đúng vai trò và mục đích.
- [ ] Chi phí đường ống và mô hình được hiển thị minh bạch theo từng khối lượng công việc.
- [ ] Các lỗi về độ mới và vi phạm SLA đều có tuyến chuyển giao xử lý được chỉ định đích danh.
- [ ] Các mô hình dự đoán có đầy đủ các cơ chế đánh giá và kiểm soát khả năng quan sát.
- [ ] Các tài sản tạo sinh có cổng kiểm duyệt an toàn thương hiệu và sự phê duyệt của con người.
- [ ] Quy trình hoàn tác và ứng phó sự cố khẩn cấp đã được kiểm thử thực tế.
- [ ] Việc chuyển đổi từ giai đoạn thử nghiệm sang sản xuất đòi hỏi mọi chốt kiểm soát quan trọng phải vượt qua.
Bạn muốn đánh giá danh mục này trên chính hệ thống công nghệ hiện tại của mình? Hãy yêu cầu Van Data Team thực hiện một đợt đánh giá miễn phí thông qua các dịch vụ nền tảng của Vanaxity. Bạn sẽ nhận được bản đồ tín hiệu, phân tích lỗ hổng đường ống và bảng điều khiển, rủi ro kiểm soát và phạm vi triển khai cụ thể.
Câu hỏi thường gặp
Chúng tôi cần một CDP hay một kho dữ liệu cho tiếp thị AI?
Hãy dựa trên sự phù hợp của khối lượng công việc, không dựa vào nhãn danh mục tiếp thị. Một CDP phù hợp cho việc kích hoạt đối tượng do các nhà tiếp thị trực tiếp điều hành. Kiến trúc thuần kho dữ liệu phù hợp cho các sản phẩm dữ liệu tái sử dụng, phân tích tùy biến và các mô hình dự đoán riêng. Mô hình lai có thể bảo tồn khung quản trị của kho dữ liệu trong khi tận dụng CDP để kích hoạt nhanh chóng. Hãy đưa ra quyết định sau khi lập bản đồ về độ trễ, sự đồng ý, danh tính, tính linh hoạt dữ liệu, chi phí và quyền sở hữu.
Tại sao cần tách biệt dữ liệu dùng chung khỏi hạ tầng điện toán xử lý?
Sự tách biệt cho phép các đội ngũ tái sử dụng dữ liệu có quản trị trong khi các khối lượng công việc có thể mở rộng, gặp sự cố và phát sinh chi phí một cách độc lập mà không ảnh hưởng đến nhau. Mô hình triển khai được ghi nhận của WPP áp dụng nguyên tắc này. Vanaxity khuyến nghị bảo tồn nguyên tắc kiến trúc đó ngay cả khi một nền tảng đám mây hoặc ngăn xếp dữ liệu khác triển khai bằng các dịch vụ khác nhau.
Mô hình data mesh có bắt buộc đối với một nền tảng tiếp thị AI không?
Không bắt buộc. Data mesh là một phương thức vận hành, không phải một sản phẩm hay cấu trúc mạng cứng nhắc. Các đội ngũ miền nghiệp vụ có thể sở hữu các sản phẩm dữ liệu hữu ích dưới các hợp đồng dùng chung, quy tắc truy cập và tiêu chuẩn chất lượng thống nhất. Mục tiêu tối thượng là sự tái sử dụng đáng tin cậy và ý nghĩa nhất quán, không phải việc tuân thủ một nhãn kiến trúc lý thuyết.
Các đội ngũ nên xử lý độ lệch lược đồ và việc xử lý bù dữ liệu như thế nào?
Hãy phát hiện các thay đổi lược đồ trước khi dữ liệu chạm tới các mô hình AI hoặc công cụ kích hoạt. Quản lý phiên bản cho các hợp đồng dữ liệu, cách ly các bản ghi không tương thích và đảm bảo các lượt thử lại diễn ra an toàn. Quy trình xử lý bù (backfill) phải tái hiện đúng logic chuẩn hóa đã được duyệt và bảo tồn nguồn gốc dữ liệu. Chạy lại các bước đánh giá trước khi khôi phục quy trình nhắm mục tiêu hoặc tạo sinh tài sản.
Các nhà lãnh đạo nên đo lường điều gì trước khi đánh giá hiệu suất mô hình?
Hãy bắt đầu từ độ tin cậy của dữ liệu: độ mới, tỷ lệ thành công của đường ống, hành vi thử lại, độ bao phủ nguồn gốc, tuân thủ cam kết SLA, thực thi sự đồng ý và chi phí. Sau đó mới đánh giá chất lượng dự đoán hoặc chất lượng tài sản tạo sinh. Sản phẩm đầu ra của mô hình dù có vẻ tốt nhưng được xây dựng trên dữ liệu cũ kỹ hoặc thiếu quản trị sẽ không thể tạo nên một hệ thống đáng tin cậy.
Vertex AI và các mô hình tạo sinh nằm ở vị trí nào trong kiến trúc này?
Chúng nằm phía trên tầng dữ liệu và đường ống có quản trị. Trong mô hình Google Cloud của WPP, BigQuery và dữ liệu đối tượng chuẩn hóa hỗ trợ cho Vertex AI và các mô hình tạo sinh của Google. Các doanh nghiệp khác có thể sử dụng các nền tảng công nghệ khác trong khi vẫn duy trì ranh giới rõ ràng giữa dữ liệu đáng tin cậy, thực thi mô hình, đánh giá chất lượng và kích hoạt ra thị trường.