Nền tảng dữ liệu phía sau nghiên cứu tìm kiếm AI
GEO và AEO không chỉ là bài toán nội dung. Phía sau khả năng được trích dẫn là một quy trình thu thập dữ liệu, kiểm tra và báo cáo đáng tin cậy.
Nội dung nằm ở hạ nguồn của dữ liệu
Khi nhìn vào một gói nội dung GEO hoặc AEO tốt, người ta dễ chỉ thấy phần viết: một câu trả lời rõ ràng, cấu trúc gọn gàng, nêu đúng tên các thực thể cần có. Nhưng phần viết chỉ là chặng cuối cùng. Trước khi Vanaxity có thể đề xuất cách trở thành câu trả lời cho một truy vấn, hệ thống phải biết các công cụ tìm kiếm và công cụ AI hiện đang trả lời truy vấn đó ra sao, chúng trích dẫn những nguồn nào và khoảng trống nằm ở đâu.
Những hiểu biết đó không có sẵn dưới dạng một bộ dữ liệu gọn gàng. Chúng phải được thu thập từ kết quả tìm kiếm thời gian thực, các công cụ trả lời và trang của đối thủ cạnh tranh, mà nhiều nguồn trong số đó chủ động ngăn chặn truy cập tự động. Vì vậy, bên dưới một quy trình nội dung có vẻ êm ả là một thực tế kém hào nhoáng hơn: nghiên cứu tìm kiếm AI trước hết là bài toán thu thập dữ liệu, pipeline và báo cáo, sau đó mới là bài toán nội dung.
Bạn không thể dựng nên một câu trả lời tốt hơn chính dữ liệu ban đầu của mình. Mức trần chất lượng của công việc GEO và AEO được xác lập ở tầng thu thập, không phải ở tầng viết.
Ba tác vụ dữ liệu đằng sau mỗi lượt nghiên cứu
Mỗi lượt nghiên cứu của Vanaxity về một chủ đề đều âm thầm chạy ba tác vụ dữ liệu trước khi một đề xuất nào được viết ra.
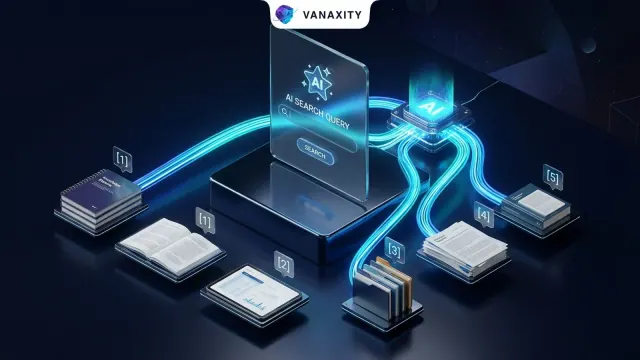
- Thu thập: lấy về bức tranh thời gian thực, tức là các trang đang xếp hạng, AI Overview và câu trả lời của các công cụ trả lời, nhóm câu hỏi People Also Ask và nội dung của đối thủ hiện đang chiếm lĩnh truy vấn.
- Trích xuất: biến HTML lộn xộn, các trang đã render và văn bản câu trả lời thành tín hiệu có cấu trúc, tức là thực thể nào được nêu tên, nguồn nào được trích dẫn, câu trả lời được trình bày theo cách nào và khoảng trống về độ bao phủ nằm ở đâu.
- Báo cáo: tổng hợp các tín hiệu đó thành thứ mà con người có thể rà soát và hành động theo, tức là một góc nhìn có cơ sở vững chắc về khoảng cách giữa vị trí hiện tại của thương hiệu và những gì cần làm để trở thành câu trả lời được trích dẫn.
Không tác vụ nào trong ba tác vụ đó là script chạy một lần rồi bỏ. Kết quả tìm kiếm thay đổi, công cụ trả lời thay đổi cách trích dẫn, còn các nguồn được bảo vệ thay đổi cách chặn. Làm việc này một cách đáng tin cậy, tuần này qua tuần khác, mới là chỗ đòi hỏi kỷ luật kỹ thuật.
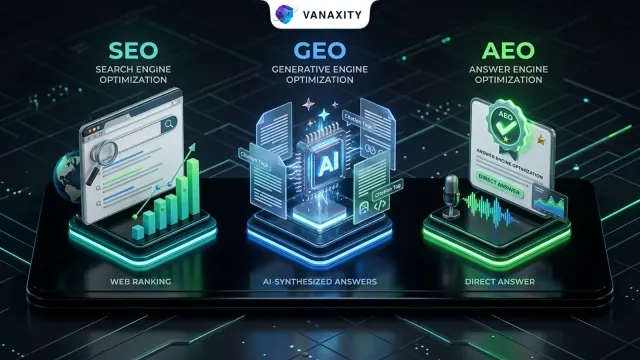
Xác định quy trình SEO, GEO và AEO phù hợp trước khi triển khai.
Vì sao thu thập dữ liệu là phần khó
Cách thu thập ngây thơ, tức một script viết nhanh để tải một trang, gần như hỏng ngay lập tức khi lên quy mô nghiên cứu. Các nguồn tìm kiếm và trang của đối thủ đều động, được cá nhân hóa, bị giới hạn tốc độ truy cập và thường chủ động chống bot. Một hệ thống nghiên cứu âm thầm bắt đầu trả về dữ liệu rỗng hoặc thiếu sót còn tệ hơn là không có hệ thống nào, vì nội dung được xây dựng trên nó sẽ thừa hưởng điểm mù đó.
Vì vậy, tầng thu thập cần những đặc tính mà bất kỳ pipeline dữ liệu production nào cũng cần: chiến lược proxy và phiên làm việc cho các nguồn được bảo vệ, cơ chế thử lại và giãn thời gian chờ (backoff), giám sát để nhận biết khi một nguồn bắt đầu lỗi, và xác thực để dữ liệu thiếu sót không bao giờ âm thầm làm sai lệch kết quả phân tích. Đây chính là kỷ luật vận hành đằng sau các hệ thống web scraping và tự động hóa bền vững, chứ không phải một công cụ cào dữ liệu viết vội trong một dịp cuối tuần.
Vanaxity không tuyên bố sở hữu một nguồn dữ liệu tìm kiếm hoàn hảo, dồi dào như có phép màu. Điều Vanaxity khẳng định là một tầng thu thập được giám sát và xác thực, khi gặp sự cố sẽ báo lỗi rõ ràng thay vì im lặng, để phần nghiên cứu dựa trên tầng này có thể được tin cậy, hoặc được gắn cờ rõ ràng khi một nguồn bị suy giảm.
Từ tín hiệu thô đến quyết định mà con người có thể rà soát
| Tác vụ nghiên cứu | Thách thức về dữ liệu | Kỷ luật kỹ thuật cần có |
|---|---|---|
| Nắm bắt SERP và các bề mặt câu trả lời thời gian thực | Các nguồn động, được cá nhân hóa, bị giới hạn tốc độ truy cập và chống bot, khiến cách tải trang ngây thơ bị hỏng. | Web scraping và tự động hóa có hỗ trợ proxy, được giám sát, kèm cơ chế thử lại và xác thực. |
| Trích xuất thực thể, trích dẫn và khoảng trống | HTML lộn xộn và văn bản câu trả lời không có cấu trúc nhất quán giữa các nguồn. | Các pipeline phân tích cú pháp (parsing) và biến đổi, chuyển trang thô thành tín hiệu sạch, có thể truy vấn. |
| Báo cáo khoảng trống cho người rà soát | Tín hiệu vô dụng cho đến khi con người có thể thấy điều gì đã thay đổi và cần làm gì tiếp theo. | Một tầng báo cáo có quản trị, tóm tắt các biến động và gắn cờ những gì cần hành động. |
Dòng cuối cùng quan trọng hơn vẻ bề ngoài của nó. Một đống tín hiệu cào về chưa phải là insight. Giá trị xuất hiện khi dữ liệu được tổng hợp vào một giao diện báo cáo mà người làm marketing hoặc nhà sáng lập thực sự có thể rà soát, cùng dạng bài toán với việc biến một kho dữ liệu đầy sự kiện thô thành một bản tường thuật mà ban lãnh đạo đọc hiểu được. Vanaxity đặt một bước duyệt của con người đúng tại điểm này, để một người xác nhận cách diễn giải dữ liệu trước khi bất kỳ quyết định nào về nội dung được đưa ra.
Đội ngũ kỹ thuật đứng sau tầng nghiên cứu
Vanaxity được xây dựng bởi Van Data Team, đội ngũ có công việc cốt lõi chính là những hệ thống không hào nhoáng nhưng đóng vai trò nền móng này: thu thập dữ liệu khó lấy, đưa dữ liệu qua các pipeline đáng tin cậy và biến dữ liệu thành báo cáo có quản trị. Tầng nghiên cứu tìm kiếm AI không phải là một chuyên môn tách biệt khỏi kỹ thuật dữ liệu; đó là kỹ thuật dữ liệu nhắm vào SERP.
Câu hỏi thường gặp về dữ liệu đằng sau nghiên cứu tìm kiếm AI
Vì sao nghiên cứu GEO và AEO lại cần đến web scraping?
Vì sự thật nền (ground truth) nằm trên các bề mặt tìm kiếm và trả lời thời gian thực, cũng như trên trang của đối thủ, chứ không nằm trong một API gọn gàng. Để biết một truy vấn hiện đang được trả lời và trích dẫn như thế nào, bạn phải thu thập SERP thời gian thực, AI Overviews, câu trả lời của các công cụ trả lời và nội dung của đối thủ, mà nhiều trong số đó là nội dung động hoặc có cơ chế chống bot. Việc thu thập đó là một bài toán web scraping và tự động hóa.
Dữ liệu thu thập được có đủ tin cậy để làm cơ sở cho các quyết định nội dung không?
Chỉ khi tầng thu thập được giám sát và xác thực. Một công cụ scraping âm thầm trả về dữ liệu thiếu sót là nguy hiểm, vì nội dung sẽ thừa hưởng điểm mù đó. Cách tiếp cận của Vanaxity là làm cho pipeline báo lỗi rõ ràng và gắn cờ các nguồn bị suy giảm, để người rà soát biết khi nào nên tin vào cách diễn giải dữ liệu và khi nào nên tạm dừng.
Điều này khác gì so với một công cụ từ khóa?
Công cụ từ khóa đưa cho bạn các chỉ số. Tầng này thu thập toàn cảnh câu trả lời thời gian thực, trích xuất thực thể và các mẫu trích dẫn, báo cáo khoảng cách giữa vị trí hiện tại của thương hiệu và những gì cần làm để trở thành câu trả lời được trích dẫn, rồi chuyển kết quả đó đến một bước duyệt của con người trước khi bất kỳ nội dung nào được tạo ra.
Tìm hiểu hệ thống và đội ngũ