Claude Sonnet 5.5 hay Opus 5.5: mô hình nào hợp với công việc marketing?
Claude Sonnet 5.5 và Opus 5.5 cho marketing: gần ngang nhau về tài liệu và tự động hóa, nhưng Opus ít lỗi sự thật hơn hẳn. Nên dùng mô hình nào cho từng việc.
Tổng quan
Cuộc so sánh giữa Claude Sonnet 5.5 và Opus 5.5 thực chất là bài toán cân nhắc giữa tốc độ và độ chính xác. Trên các bài kiểm tra độc lập, hai mô hình gần như hòa nhau về năng lực xử lý tài liệu, bảng tính và tự động hóa ở mức cấu hình tối đa, và Opus 5.5 thậm chí có chi phí trên mỗi tác vụ thấp hơn ở phân khúc đó. Tuy nhiên, Opus 5.5 mắc ít lỗi thực tế hơn rất nhiều. Sonnet 5.5 bắt đầu phản hồi nhanh hơn và có chi phí thấp hơn ở các mức cấu hình thông dụng hàng ngày, vì vậy đối với công việc tiếp thị, hãy lựa chọn theo từng nhiệm vụ cụ thể.
Anthropic phát hành Claude Opus 5.5 vào ngày 22 tháng 9 năm 2026, và Claude Sonnet 5.5 sáu ngày sau đó. Cả hai đều đủ mạnh mẽ cho hầu hết các công việc tiếp thị hiện đại, vì vậy câu hỏi then chốt là mỗi mô hình xứng đáng với chi phí bỏ ra ở khâu nào.
**Ghi chú về quan điểm:** bài viết này được nghiên cứu và phác thảo với sự hỗ trợ của Claude, và Anthropic là đơn vị phát triển cả hai mô hình được so sánh tại đây. Vì vậy, chúng tôi dẫn dắt bằng dữ liệu kiểm nghiệm độc lập từ Artificial Analysis và chỉ rõ những điểm yếu của từng mô hình. Các hướng dẫn về tiếp thị là quan điểm phân tích của riêng chúng tôi.
Điểm cốt lõi
- Sonnet 5.5 có giá 2 USD cho mỗi triệu token đầu vào và 10 USD cho mỗi triệu token đầu ra. Opus 5.5 có giá 4 USD và 20 USD, đắt gấp đôi.
- Ở cấu hình tối đa, cả hai gần như ngang ngửa trong công việc tri thức: đạt 1844 so với 1846 điểm trên bài kiểm tra GDPval-AA, và 71% so với 70% trên các tác vụ tự động hóa.
- Opus 5.5 đáng tin cậy hơn nhiều về tính chính xác thực tế. Trên bài kiểm tra AA-Omniscience, mô hình đạt 46 điểm so với 32 của Sonnet ở cấu hình tối đa, và đạt điểm số gấp đôi ở các cấu hình thấp hơn.
- Ở cấu hình tối đa, Opus 5.5 thực chất có chi phí trên mỗi tác vụ thấp hơn, 5,98 USD so với 7,60 USD, bởi Sonnet 5.5 sinh ra nhiều token hơn đáng kể.
- Sonnet 5.5 vượt trội về tốc độ. Ở mức nỗ lực thấp, mô hình bắt đầu đưa ra câu trả lời trong chưa đầy một giây, trong khi Opus 5.5 mất khoảng 12 giây.
Xác định quy trình SEO, GEO và AEO phù hợp trước khi triển khai.
Claude Sonnet 5.5 và Opus 5.5 là gì?
Đây là hai mô hình mới nhất của Anthropic: Opus 5.5 là phiên bản cao cấp đầu bảng, còn Sonnet 5.5 là phiên bản nhanh hơn, tối ưu chi phí hơn. Dưới đây là các thông số cơ bản:
| Claude Sonnet 5.5 | Claude Opus 5.5 | |
|---|---|---|
| Ngày phát hành | 28 tháng 9 năm 2026 | 22 tháng 9 năm 2026 |
| Giá token đầu vào / triệu token | 2 USD | 4 USD |
| Giá token đầu ra / triệu token | 10 USD | 20 USD |
| Giá đầu vào lưu đệm / triệu token | 0,20 USD | 0,20 USD |
| Ngữ cảnh xử lý (context window) | 1 triệu token | 1 triệu token |
| Điểm chỉ số Artificial Analysis cao nhất | 56 | 58 |
Anthropic định vị Sonnet 5.5 là đối tác tốc độ song hành cùng Opus 5.5, vượt trội ở các công việc hàng ngày có phạm vi xác định rõ ràng và sản xuất tài liệu, slide thuyết trình, bảng tính hoàn chỉnh. Hãng cho biết Opus 5.5 vẫn mạnh mẽ hơn ở các bài toán phức tạp, mở và đòi hỏi tư duy đa tầng. Sonnet 5.5 hiện khả dụng trên nền tảng của Anthropic cũng như trên AWS, Google Cloud và Microsoft Azure.
So sánh Claude Sonnet 5.5 và Opus 5.5 ở cấu hình tối đa
Hai mô hình gần như hòa nhau ở các công việc mà giới tiếp thị thực hiện nhiều nhất, nhưng có một khoảng cách lớn về dữ liệu thực tế. Dưới đây là kết quả ở mức nỗ lực tối đa trên Chỉ số Trí tuệ của Artificial Analysis, phiên bản 4.3.2:
| Bài kiểm tra | Sonnet 5.5 (tối đa) | Opus 5.5 (tối đa) |
|---|---|---|
| Chỉ số Trí tuệ (Intelligence Index) | 56 | 58 |
| GDPval-AA (tài liệu, slide, bảng tính) | 1844 | 1846 |
| AA-Briefcase (nhiệm vụ chuyên môn) | 1811 | 1822 |
| AutomationBench-AA | 71% | 70% |
| AA-LCR (tài liệu dài) | 83% | 85% |
| Humanity's Last Exam (suy luận phức tạp) | 55% | 61% |
| AA-Omniscience (độ chính xác thực tế) | 32 | 46 |
| Chi phí trên mỗi tác vụ | 7,60 USD | 5,98 USD |
Trên các sản phẩm bàn giao thực tế, khoảng cách là rất nhỏ. GDPval-AA yêu cầu mô hình tạo ra các ấn phẩm công việc thực thụ như báo cáo, slide và bảng tính, và hai mô hình chỉ chênh lệch nhau 2 điểm. Sonnet 5.5 thậm chí còn nhỉnh hơn một chút trên các tác vụ tự động hóa.
Khoảng cách đáng kể nhất nằm ở độ chính xác thực tế, với tỷ số 46 so với 32. Opus 5.5 cũng dẫn đầu về năng lực suy luận phức tạp.
Bên cạnh đó là bất ngờ về chi phí: ở mức nỗ lực tối đa, Opus 5.5 có chi phí trên mỗi tác vụ rẻ hơn. Sonnet 5.5 đã sử dụng khoảng 193.000 token đầu ra cho mỗi tác vụ so với 119.000 của Opus 5.5, vì vậy mức giá token rẻ hơn không giúp tiết kiệm chi phí trong trường hợp này.
So sánh Claude Sonnet 5.5 và Opus 5.5 ở mức ngân sách thông dụng
Hầu hết các đội ngũ tiếp thị sẽ không chạy mô hình ở mức nỗ lực tối đa cho mọi việc. Dưới đây là phép so sánh công bằng hơn ở các mức chi phí tương đương: Sonnet 5.5 ở mức nỗ lực cao so với Opus 5.5 ở mức nỗ lực trung bình.
| Bài kiểm tra | Sonnet 5.5 (mức cao) | Opus 5.5 (mức trung bình) |
|---|---|---|
| Chỉ số Trí tuệ | 47 | 51 |
| GDPval-AA | 1517 | 1576 |
| AA-Briefcase | 1634 | 1642 |
| AutomationBench-AA | 59% | 61% |
| AA-LCR (tài liệu dài) | 78% | 84% |
| AA-Omniscience (độ chính xác thực tế) | 21 | 40 |
| Chi phí trên mỗi tác vụ | 1,08 USD | 1,34 USD |
| Thời gian đến token đầu tiên | 17 giây | 22 giây |
Ở cấu hình này, Opus 5.5 giành chiến thắng trên toàn bộ mười bài kiểm tra với chi phí cao hơn khoảng 24% cho mỗi tác vụ. Chênh lệch ở mảng tài liệu và tự động hóa là khiêm tốn. Nhưng chênh lệch về độ chính xác dữ liệu là rất lớn: Opus 5.5 đạt điểm số gần gấp đôi Sonnet.
Ở mức nỗ lực thấp, kịch bản tương tự lặp lại. Opus 5.5 tiếp tục thắng cả mười bài kiểm tra, đạt 39 điểm độ chính xác thực tế so với 19 điểm của Sonnet, với chi phí 0,55 USD so với 0,41 USD cho mỗi tác vụ, theo Artificial Analysis. Lợi thế lớn nhất mà Sonnet 5.5 mang lại ở phân khúc này chính là tốc độ, được phân tích chi tiết bên dưới.
Vì sao tính chính xác thực tế lại tối quan trọng trong tiếp thị?
Bởi vì những sai lầm xuất bản sẽ lan truyền rất xa. Một số liệu thống kê sai lệch trong bài blog, trang sản phẩm hoặc thông cáo báo chí sẽ không dừng lại ở đó. Khách hàng sẽ trích dẫn lại, các trang khác sẽ dẫn nguồn và các công cụ tìm kiếm AI có thể trích dẫn lại thông tin sai đó cho những người tìm kiếm sau này.
Chỉ số AA-Omniscience đo lường chính xác rủi ro này. Bài kiểm tra đặt các câu hỏi về dữ liệu thực tế, cộng điểm cho câu trả lời đúng và trừ điểm nặng cho câu trả lời sai, trong khi mô hình nói 'Tôi không biết' sẽ không bị trừ điểm. Do đó, điểm số cao hơn đồng nghĩa với việc ít đưa ra các khẳng định sai lầm một cách tự tin.
Điều này biến khoảng cách chính xác trở thành con số quan trọng nhất đối với các đội ngũ nội dung. Ở mọi mức cấu hình được đánh giá, Opus 5.5 đều đạt điểm số vượt trội:
- **Mức nỗ lực thấp:** Opus 5.5 đạt 39 điểm, Sonnet 5.5 đạt 19 điểm.
- **Cấu hình thông dụng hàng ngày:** Opus 5.5 ở mức trung bình đạt 40 điểm, Sonnet 5.5 ở mức cao đạt 21 điểm.
- **Cấu hình tối đa:** Opus 5.5 đạt 46 điểm, Sonnet 5.5 đạt 32 điểm.
**Quan điểm của chúng tôi:** đối với nội dung được xuất bản công khai và có khả năng được trích dẫn, chi phí bổ sung của Opus 5.5 là khoản bảo hiểm rất rẻ. Điều này càng có ý nghĩa khi tìm kiếm AI ngày càng phát triển, bởi các công cụ AI có xu hướng lặp lại những gì chúng tìm thấy, như chúng tôi đã phân tích trong cẩm nang tối ưu trích dẫn. Dù vậy, con người vẫn luôn cần kiểm tra lại mọi dữ kiện thực tế trước khi xuất bản.
So sánh tốc độ giữa Claude Sonnet 5.5 và Opus 5.5
Sonnet 5.5 chiếm ưu thế rõ ràng trên cả hai thước đo tốc độ quan trọng: tốc độ sinh văn bản nhanh hơn và thời gian bắt đầu phản hồi sớm hơn rất nhiều ở cấu hình thấp.
- **Tốc độ sinh văn bản:** Artificial Analysis đo lường Sonnet 5.5 đạt khoảng 85 đến 139 token mỗi giây trên các cấu hình, so với 74 đến 94 token mỗi giây của Opus 5.5.
- **Thời gian đến token đầu tiên ở nỗ lực thấp:** Sonnet 5.5 bắt đầu phản hồi trong khoảng 0,9 giây. Opus 5.5 mất khoảng 12 giây.
- **Thời gian đến token đầu tiên ở cấu hình tối đa:** cả hai mô hình đều suy nghĩ trong vài phút trước khi bắt đầu trả lời, vì vậy không mô hình nào phù hợp cho tương tác trực tiếp ở mức tối đa.
Đối với một trợ lý trò chuyện trên website hoặc một công cụ mà đội ngũ của bạn sử dụng cả ngày, khoảng thời gian một giây đầu tiên là cực kỳ quan trọng. Một câu trả lời bắt đầu ngay lập tức tạo cảm giác tức thì, trong khi câu trả lời xuất hiện sau 12 giây sẽ khiến người dùng nghĩ hệ thống đang bị lỗi.
Claude Sonnet 5.5 hay Opus 5.5 phù hợp cho từng nhiệm vụ tiếp thị?
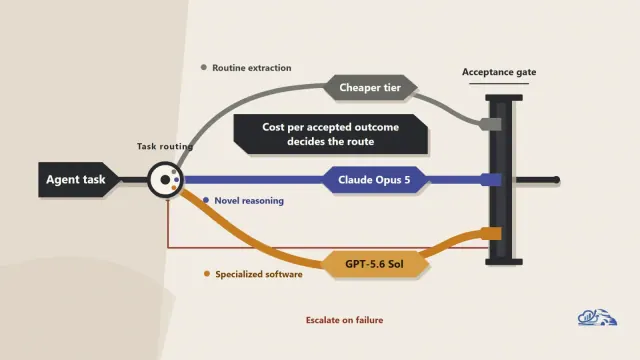
Hãy ghép đúng mô hình cho từng công việc. Dưới đây là phương án định tuyến công việc tiếp thị tiêu chuẩn dựa trên các kết quả thử nghiệm:
| Nhiệm vụ | Lựa chọn tốt hơn | Lý do |
|---|---|---|
| Bài viết định hướng tư duy và nghiên cứu chuyên sâu | Opus 5.5 | Ít lỗi thực tế hơn nhiều đối với nội dung sẽ được trích dẫn |
| Trang sản phẩm và trang so sánh giải pháp | Opus 5.5 | Độ chính xác cao về thông số kỹ thuật, giá cả và tính năng |
| Báo cáo, slide thuyết trình và bảng tính | Cả hai mô hình | Điểm số gần như ngang nhau trên bài kiểm tra GDPval-AA |
| Biến thể quảng cáo và email số lượng lớn | Sonnet 5.5 | Nhanh hơn và tiết kiệm hơn ở mức nỗ lực thấp và trung bình |
| Bản nháp bài đăng mạng xã hội | Sonnet 5.5 | Tốc độ là ưu tiên hàng đầu, và con người vẫn sẽ chỉnh sửa lại |
| Trợ lý trò chuyện trực tiếp trên website | Sonnet 5.5 (nỗ lực thấp) | Bắt đầu phản hồi trong chưa đầy một giây |
| Tác nhân tự động hóa quy trình tiếp thị | Cả hai mô hình | Năng lực xử lý nhiệm vụ tự động hóa gần như tương đương |
| Tóm tắt tài liệu thương hiệu hoặc nghiên cứu dài | Opus 5.5 | Khả năng suy luận trên tài liệu dài nhỉnh hơn một chút |
Mô hình phối hợp hai tầng mang lại hiệu quả rất cao: Sonnet 5.5 đảm nhận soạn thảo bản nháp tốc độ cao, và Opus 5.5 đảm nhận kiểm tra tính xác thực thực tế cho mọi nội dung sẽ được xuất bản dưới tên thương hiệu của bạn.
Chi phí ước tính cho một chương trình nội dung
Dưới đây là ước tính chi phí cho 1.000 nhiệm vụ dựa trên đơn giá tác vụ của Artificial Analysis. Đây là các nhiệm vụ kiểm nghiệm phức tạp, vì vậy một yêu cầu viết blog hoặc bộ quảng cáo thông thường có thể tốn ít chi phí hơn nhiều. Tỷ lệ so sánh mới là điều quan trọng:
| Mô hình và cấu hình | Chi phí trên mỗi nhiệm vụ | Chi phí trên 1.000 nhiệm vụ |
|---|---|---|
| Sonnet 5.5 (nỗ lực thấp) | 0,41 USD | 410 USD |
| Opus 5.5 (nỗ lực thấp) | 0,55 USD | 550 USD |
| Sonnet 5.5 (nỗ lực cao) | 1,08 USD | 1.080 USD |
| Opus 5.5 (nỗ lực trung bình) | 1,34 USD | 1.340 USD |
| Opus 5.5 (nỗ lực tối đa) | 5,98 USD | 5.980 USD |
| Sonnet 5.5 (nỗ lực tối đa) | 7,60 USD | 7.600 USD |
Hóa đơn API của mô hình hiếm khi là chi phí lớn nhất trong sản xuất nội dung. Thời gian chỉnh sửa của con người mới là khoản chi phí đáng kể nhất. Nếu Opus 5.5 giúp biên tập viên tiết kiệm mười phút kiểm tra dữ kiện cho mỗi bài viết, mô hình này sẽ tự hoàn vốn nhiều lần so với mức chênh lệch chi phí. Chúng tôi đã phân tích sâu hơn về nơi tiêu tốn thời gian thực sự trong bài viết về nút thắt thời gian sản xuất marketing AI.
Đội ngũ tiếp thị nên thử nghiệm cả hai mô hình như thế nào?
Hãy thử nghiệm trên chính các yêu cầu thực tế của bạn, không phải các mẫu chuẩn có sẵn. Một quy trình tinh gọn:
- **Chọn 20 đến 30 yêu cầu công việc thực tế** bao gồm các định dạng chính như bài blog, trang sản phẩm, quảng cáo và email.
- **Chạy cả hai mô hình ở hai mức cấu hình mỗi loại,** chẳng hạn như Sonnet 5.5 ở mức thấp và cao, Opus 5.5 ở mức thấp và trung bình.
- **Đếm số lỗi thực tế** trong từng kết quả đầu ra, được con người đối chiếu cẩn thận với tài liệu nguồn.
- **Bấm giờ thời gian chỉnh sửa:** đo lường số phút biên tập viên cần để biến bản nháp thành ấn phẩm có thể xuất bản, bởi thời gian biên tập là chi phí lớn nhất.
- **Chấm điểm giọng văn thương hiệu** theo một biểu tiêu chí ngắn gọn.
- **So sánh tổng chi phí thực tế:** chi phí API cộng với chi phí thời gian biên tập cho mỗi ấn phẩm.
Hầu hết các đội ngũ có thể hoàn thành bài thử nghiệm này trong vòng một tuần. Kết quả mang lại một nguyên tắc định tuyến vững chắc có thể bảo vệ được trước ban lãnh đạo. Để giữ cho các bản nháp AI luôn mang đậm bản sắc thương hiệu, hãy tham khảo cẩm nang tạo chất nhân bản cho nội dung AI của chúng tôi.
Những yếu tố nào có thể làm thay đổi quyết định lựa chọn mô hình?
Ba diễn biến đáng quan sát trong những tháng tới:
- **Sự ra mắt của Haiku 5.5:** mô hình nhỏ nhất của Anthropic dự kiến sẽ ra mắt trong vài tuần tới theo VentureBeat, và nó có thể đảm nhận các tác vụ soạn thảo số lượng lớn với chi phí rẻ nhất từ Sonnet 5.5.
- **Dữ liệu thử nghiệm cập nhật:** các chỉ số hiện tại là điểm đánh giá độc lập ban đầu. Artificial Analysis liên tục cập nhật kết quả khi chạy lại các bài kiểm tra, vì vậy hãy theo dõi số liệu mới nhất.
- **Dữ liệu vận hành nội bộ:** sau một tháng sử dụng thực tế, tỷ lệ lỗi và thời gian biên tập của chính đội ngũ bạn sẽ có giá trị thực tiễn hơn bất kỳ bảng điểm chuẩn nào. Hãy đánh giá lại mỗi quý.
Dù kịch bản nào diễn ra, nguyên lý định tuyến vẫn giữ nguyên giá trị: sử dụng mô hình có độ chính xác cao cho những nội dung xuất bản dưới tên thương hiệu của bạn, và sử dụng mô hình tốc độ cho những công việc có con người rà soát trước khi chuyển giao.
Cách Vanaxity giúp các đội ngũ lựa chọn mô hình AI cho tiếp thị
Chúng tôi xây dựng các hệ thống nội dung kết hợp hài hòa giữa tốc độ và độ chuẩn xác. Điều đó đồng nghĩa với việc định tuyến từng nhiệm vụ đến đúng mô hình, thiết lập các bước kiểm chứng sự thật trước khi xuất bản và theo dõi cách nội dung của bạn xuất hiện trong các câu trả lời AI.
Cuộc so sánh giữa Claude Sonnet 5.5 và Opus 5.5 cho thấy rõ một chân lý: hiếm khi có một mô hình duy nhất phù hợp hoàn hảo cho mọi việc. Để thiết lập cơ chế định tuyến thông minh cho đội ngũ của bạn, hãy tham khảo các dịch vụ của chúng tôi hoặc khám phá thêm các bài viết phân tích.
Câu hỏi thường gặp
Sự khác biệt cốt lõi giữa Claude Sonnet 5.5 và Opus 5.5 là gì?
Opus 5.5 là mô hình cao cấp đầu bảng của Anthropic với mức giá 4 USD đầu vào và 20 USD đầu ra cho mỗi triệu token. Sonnet 5.5 là phiên bản nhanh hơn, tối ưu chi phí hơn với giá 2 USD và 10 USD. Trên các bài kiểm tra của Artificial Analysis, Opus 5.5 đạt 58 điểm ở cấu hình tối đa và Sonnet 5.5 đạt 56 điểm. Cả hai gần như hòa nhau về xử lý tài liệu và tự động hóa, nhưng Opus 5.5 vượt trội rõ rệt về độ chính xác thực tế.
Claude Opus 5.5 có xứng đáng với mức chi phí tăng thêm cho tiếp thị không?
Đối với các nội dung xuất bản công khai và có khả năng được trích dẫn, câu trả lời thường là có. Opus 5.5 đạt điểm chính xác thực tế cao gấp đôi Sonnet 5.5 ở cấu hình thấp và trung bình, với chi phí trên mỗi tác vụ chỉ cao hơn từ 24% đến 34%. Ở cấu hình tối đa, Opus 5.5 thậm chí có chi phí rẻ hơn, 5,98 USD so với 7,60 USD, do Sonnet 5.5 sinh ra nhiều token hơn.
Claude Sonnet 5.5 có đủ tốt cho nội dung tiếp thị không?
Hoàn toàn đủ tốt cho rất nhiều nhiệm vụ. Mô hình gần như ngang ngửa với Opus 5.5 trong việc tạo tài liệu, slide thuyết trình, bảng tính và tự động hóa ở cấu hình tối đa, đồng thời có tốc độ nhanh hơn. Đây là lựa chọn lý tưởng cho các bản nháp số lượng lớn, biến thể quảng cáo, email, bài đăng mạng xã hội và trợ lý trò chuyện trực tiếp. Với nội dung nặng về số liệu thực tế, bạn nên bổ sung bước kiểm chứng hoặc sử dụng Opus 5.5.
Mô hình nào nhanh hơn giữa Claude Sonnet 5.5 và Opus 5.5?
Sonnet 5.5 nhanh hơn rõ rệt. Artificial Analysis đo lường tốc độ của Sonnet 5.5 đạt khoảng 85 đến 139 token mỗi giây, so với 74 đến 94 token mỗi giây của Opus 5.5. Ở mức nỗ lực thấp, Sonnet 5.5 bắt đầu phản hồi trong khoảng 0,9 giây, trong khi Opus 5.5 mất khoảng 12 giây.
Đội ngũ tiếp thị có nên sử dụng đồng thời cả hai mô hình không?
Nhiều đội ngũ nên áp dụng phương án này. Mô hình phổ biến là sử dụng Sonnet 5.5 cho các bản nháp nhanh, biến thể nội dung và trợ lý trực tiếp, và sử dụng Opus 5.5 cho nghiên cứu chuyên sâu, kiểm chứng dữ kiện và những ấn phẩm quan trọng xuất bản dưới tên thương hiệu. Hãy thử nghiệm cả hai trên chính các yêu cầu thực tế của bạn để so sánh tổng chi phí bao gồm cả thời gian biên tập.