Kimi K3 trên AWS: blueprint tự lưu trữ tác nhân AI
AWS mô tả cách triển khai Kimi K3 với HyperPod hoặc EKS. Đây là các tiêu chí để cân nhắc chi phí, quyền kiểm soát và độ tin cậy.

Tổng quan
Nếu bạn chạy tác nhân AI trên một API được lưu trữ sẵn (hosted API), ba vấn đề sẽ âm thầm chồng chất: chi phí token khó dự đoán, sự phụ thuộc vào nhà cung cấp (vendor lock-in) và prompt bị gửi ra ngoài VPC của bạn. Các đội ngũ đang cân nhắc chạy Kimi K3 trên AWS phải đưa ra một quyết định cụ thể: liệu khả năng kiểm soát dữ liệu và sự ổn định của phiên bản mô hình có xứng đáng với chi phí và gánh nặng MLOps khi phục vụ một mô hình tác nhân 2,8 nghìn tỷ tham số trên tám GPU B300 hay không. Hướng dẫn này là cẩm nang ra quyết định cho các nhà sáng lập, đội ngũ RevOps và đội ngũ nền tảng: bài viết giải thích bản thiết kế triển khai mới với HyperPod và EKS của AWS, sự đánh đổi giữa phương án được quản lý và tự làm (DIY), cùng cách so sánh tự lưu trữ với API theo chi phí trên mỗi kết quả được chấp nhận, dựa trên cách tiếp cận của Van Data Team đối với vận hành tác nhân có quản trị và có thể quan sát.
AWS đã phát hành bản thiết kế production để triển khai Kimi K3 trên AWS thông qua SageMaker HyperPod hoặc Amazon EKS. Bản thiết kế này khiến việc doanh nghiệp tự lưu trữ một mô hình trọng số mở tiên phong trở nên khả thi, chuyển câu hỏi khó từ khả năng kỹ thuật sang bài toán kinh tế vận hành, quản trị và kết quả tác nhân đáng tin cậy.
Với các nhà sáng lập, người làm marketing và lãnh đạo RevOps, sự chuyển dịch đó quan trọng vì các tác nhân tự chủ chạm đến dữ liệu nhạy cảm và những quy trình có hệ quả lớn. Vanaxity là tác nhân nội dung AI của Van Data Team cho SEO, GEO và AEO. Vanaxity nghiên cứu, viết, minh họa, xuất bản và phân phối nội dung trên Google, AI Overviews và các công cụ trả lời. Hướng dẫn này áp dụng góc nhìn của người vận hành đó vào bản thiết kế của AWS: bộ công nghệ làm gì, lộ trình nào phù hợp và cách đánh giá mức độ sẵn sàng cho production.
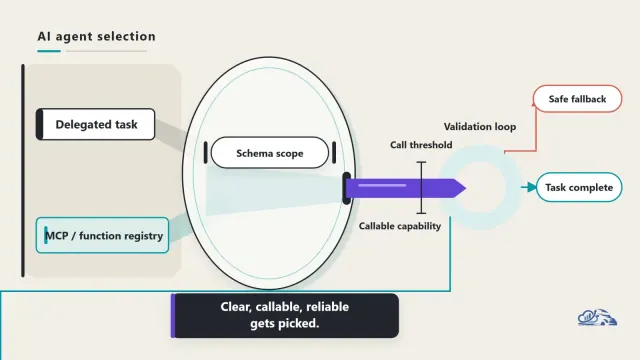
Framework tác nhân của bạn gần như không làm thay đổi quyết định này. Dù tác nhân chạy trên LangGraph, LangChain, CrewAI hay cơ chế gọi hàm gốc (native function calling) với các công cụ MCP, tất cả đều phụ thuộc vào cùng một endpoint suy luận. Điều thay đổi là kỷ luật vận hành: đặt ngân sách token cho từng quy trình tác nhân, rồi theo dõi chi phí, độ trễ, khả năng quan sát và kết quả đánh giá sau mỗi lần thay đổi mô hình hoặc prompt.
Những điểm cốt lõi cần nắm vững
- AWS cung cấp tài liệu về các lộ trình production thông qua SageMaker HyperPod và Amazon EKS thuần.
- Kimi K3 là mô hình 2,8 nghìn tỷ tham số, với khoảng 104 tỷ tham số hoạt động trên mỗi token và cửa sổ ngữ cảnh 1 triệu token.
- vLLM là engine phục vụ mô hình. MXFP4 là định dạng lượng tử hóa.
- HyperPod bổ sung phần vận hành cụm GPU được quản lý; EKS thuần để lại nhiều việc nền tảng hơn cho đội ngũ của bạn.
- Tự lưu trữ chỉ thắng thế khi nhu cầu kiểm soát, nhu cầu sử dụng duy trì liên tục và chi phí trên mỗi kết quả được chấp nhận đủ sức biện minh cho năng lực tính toán chuyên dụng.
Xác định quy trình SEO, GEO và AEO phù hợp trước khi triển khai.
AWS đã phát hành những gì cho Kimi K3 trên AWS
Hướng dẫn của AWS cung cấp cho các đội ngũ một lộ trình đưa vào production có tài liệu hướng dẫn, đi từ trọng số mở đến một endpoint suy luận sẵn sàng cho tác nhân. Theo AWS Machine Learning Blog, hướng dẫn ra mắt ngày 30/7/2026 và bao gồm hai lộ trình triển khai: SageMaker HyperPod và Amazon EKS.
AWS khuyến nghị instance ml.p6-b300.48xlarge với tám GPU NVIDIA B300 Blackwell Ultra. Các kết nối liên thông băng thông cao hỗ trợ suy luận song song tensor trên toàn bộ nhóm chuyên gia (expert pool). AWS cũng khuyến nghị vLLM vì engine này hỗ trợ phục vụ mô hình Mixture-of-Experts, song song tensor và định dạng trọng số MXFP4 của Kimi K3.
AWS nói rõ sự chuyển dịch này trong hướng dẫn triển khai chính thức của mình:
"Các mô hình trọng số mở đã đủ mạnh để xử lý những tác vụ phức tạp như quy trình tác nhân nhiều bước, suy luận nâng cao và lập trình dài hơi."
Moonshot AI phát hành trọng số mở vào ngày 27/7/2026. Đây là hệ thống trọng số mở đầu tiên thuộc phân khúc khoảng ba nghìn tỷ tham số. Thiết kế MoE của mô hình chỉ kích hoạt một phần trong toàn bộ nhóm tham số cho mỗi token. Sự phân biệt này quan trọng: tổng kích thước mô hình mô tả dung lượng, còn số tham số hoạt động giải thích rõ hơn khối lượng công việc suy luận.
Dữ kiện được báo cáo: AWS cung cấp mẫu hạ tầng, lựa chọn về cách phục vụ mô hình và các lộ trình triển khai. Phân tích của Vanaxity: bản thiết kế này chuyển cuộc tranh luận từ "Chúng ta có lưu trữ được không?" sang "Chúng ta có nên nhận lấy gánh nặng vận hành này không?"
Để thấy nghiên cứu, bước duyệt, xuất bản và phân phối khớp vào một hệ thống tự chủ như thế nào, hãy xem quy trình của tác nhân hoạt động thực tế.
Bộ công nghệ phục vụ mô hình thực sự hoạt động thế nào
Bộ công nghệ này chỉ hoạt động khi mỗi lớp có nhiệm vụ rõ ràng và người phụ trách rõ ràng. Kimi K3 cung cấp trọng số mở, kiến trúc MoE, ngữ cảnh dài và khả năng thị giác gốc (native vision). MXFP4 là định dạng lượng tử hóa nhỏ gọn được dùng để phân phối các trọng số đó. Một bài tổng quan kỹ thuật đăng trên Hugging Face giải thích mối quan hệ giữa kiến trúc, định dạng và mô hình tự lưu trữ.
vLLM là engine phục vụ mô hình. Engine này tải trọng số, lên lịch xử lý yêu cầu, quản lý suy luận và cung cấp một API mà các ứng dụng tác nhân có thể gọi. Song song tensor phân bổ khối lượng tính toán của mô hình trên các GPU được khuyến nghị để toàn bộ nhóm chuyên gia vẫn khả dụng.
Hãy phân định rõ vai trò: vLLM là engine. MXFP4 là định dạng.
Các framework tác nhân nằm phía trên endpoint đó. Chúng quản lý prompt, công cụ, bộ nhớ, trạng thái quy trình, cơ chế thử lại và việc chuyển cấp cho con người. Chúng không thay thế việc phục vụ mô hình, và việc phục vụ mô hình cũng không thay thế khâu điều phối.
Lớp dữ liệu cũng vẫn tách biệt. Tác nhân phụ thuộc vào feed, chỉ mục, bản ghi CRM, dữ liệu sản phẩm, phân quyền và API nghiệp vụ. Một mô hình mạnh được phục vụ hoàn hảo vẫn có thể cho ra kết quả tồi từ những đầu vào lỗi thời, không đầy đủ hoặc không truy được nguồn gốc.
SageMaker HyperPod và Amazon EKS
SageMaker HyperPod là lớp cụm GPU được quản lý, còn Amazon EKS thuần trao cho các đội ngũ giàu kinh nghiệm quyền kiểm soát vận hành trực tiếp hơn. Đây không phải hai công nghệ loại trừ lẫn nhau. AWS News Blog xác nhận HyperPod hỗ trợ điều phối bằng EKS bên cạnh Slurm, cùng với CLI riêng, khả năng quan sát và quản lý cụm có khả năng phục hồi.
| Yếu tố quyết định | SageMaker HyperPod với điều phối EKS | Amazon EKS thuần |
|---|---|---|
| Mô hình vận hành | Điều phối cụm GPU được quản lý, có khả năng phục hồi, bao quanh khối lượng công việc | Triển khai Kubernetes tự quản lý, với nhiều phần vận hành hơn do đội ngũ của bạn đảm nhận |
| Năng lực nền tảng | Bộ công cụ HyperPod, tự động co giãn, khả năng quan sát, quản lý tình trạng hoạt động và hỗ trợ phục hồi | Đội ngũ của bạn tự lắp ghép và vận hành nhiều phần hơn trong cụm và quy trình phục vụ mô hình tương đương |
| Phù hợp nhất với | Các đội ngũ muốn giảm khối lượng công việc tùy biến trên nền tảng GPU | Các đội ngũ có năng lực Kubernetes, GPU và SRE đã trưởng thành |
| Đánh đổi chính | Nhiều lớp trừu tượng được quản lý hơn và quy trình do AWS định nghĩa | Kiểm soát trực tiếp hơn và nhiều trách nhiệm vận hành hơn |
| Trách nhiệm bạn vẫn giữ | Đánh giá (eval), quản trị phiên bản, bảo mật endpoint, quyền truy cập dữ liệu và cơ chế kiểm soát tác nhân | Các nhiệm vụ tương tự, cộng thêm nhiều công việc vận hành cụm, năng lực tính toán và phục vụ mô hình hơn |
Khuyến nghị của chúng tôi khá đơn giản. Hãy chọn HyperPod khi mô hình mang tính chiến lược nhưng điều phối GPU không phải là lợi thế khác biệt của bạn. Hãy thử nghiệm EKS thuần khi đội ngũ nền tảng của bạn đã vận hành những khối lượng công việc Kubernetes khắt khe và muốn kiểm soát sâu hơn.
Đừng chọn EKS chỉ vì nó trông quen thuộc trên một slide kiến trúc. Quy mô của Kimi K3 khiến năng lực tính toán, việc tải mô hình, khôi phục sau lỗi và phục vụ phân tán trở thành một phần độ tin cậy của sản phẩm. Đội ngũ của bạn nên biết trước mình sẽ chẩn đoán thế nào khi việc tải mô hình bị treo, worker GPU gặp sự cố, hàng đợi phình to và dịch vụ lỗi một phần.
Trong hướng dẫn, AWS cũng tách riêng khâu mua năng lực tính toán. HyperPod dùng Flexible Training Plans, còn lộ trình EKS thuần dùng EC2 Capacity Blocks. Điều đó có nghĩa là tình trạng sẵn có, thời điểm đặt trước và kế hoạch khôi phục thuộc về quyết định nền tảng, chứ không phải một đầu việc mua sắm để sau.
Khi nào tự lưu trữ vượt trội hơn API được lưu trữ sẵn
Tự lưu trữ vượt trội hơn API được lưu trữ sẵn khi yêu cầu kiểm soát và nhu cầu ổn định có sức nặng lớn hơn năng lực GPU cố định và nhân công vận hành nền tảng. Tự lưu trữ không tự động rẻ hơn, riêng tư hơn hay dễ hơn chỉ vì trọng số được mở.
Một hệ thống tự lưu trữ được cấu hình đúng có thể giữ prompt, ngữ cảnh được truy xuất và lưu lượng mô hình bên trong ranh giới bảo mật VPC của bạn. Đội ngũ của bạn cũng kiểm soát chính xác phiên bản mô hình đứng sau các tác nhân. Điều đó bảo vệ quy trình khỏi việc nhà cung cấp thượng nguồn thay đổi mô hình hoặc lịch ngừng hỗ trợ mà không khớp với quy trình phát hành của bạn.
Lợi ích về quyền riêng tư vẫn phụ thuộc vào kiến trúc. Nhật ký, dữ liệu truy vết, dữ liệu giám sát được xuất ra, artifact của mô hình và quyền truy cập hỗ trợ đều có thể vượt ra ngoài ranh giới nếu được cấu hình cẩu thả. Hãy coi các quy tắc mã hóa, lưu lượng ra (egress), lưu giữ và kiểm toán là yêu cầu khi triển khai.
Quản lý phiên bản cũng tạo ra trách nhiệm. Đội ngũ của bạn quyết định khi nào cập nhật, nhưng cũng phải đảm nhận các bản vá bảo mật, các thành phần phụ thuộc của hệ thống phục vụ, kiểm thử tương thích và hoàn tác. Trọng số mở loại bỏ một sự phụ thuộc; chúng không loại bỏ việc quản lý phát hành.
Tự lưu trữ thay sự phụ thuộc trực tiếp vào nhà cung cấp theo từng token bằng chi phí hạ tầng và vận hành do bạn kiểm soát. Tuy vậy, năng lực Blackwell Ultra được khuyến nghị là một cam kết cố định đáng kể. GPU nhàn rỗi, mức sử dụng thấp, tác vụ thất bại và chi phí nhân sự có thể xóa sạch lợi thế giá token tưởng như có được.
API Kimi K3 được lưu trữ sẵn hoặc API của một mô hình tiên phong khác thường là điểm khởi đầu tốt hơn cho lưu lượng chưa chắc chắn, tăng đột biến theo đợt hoặc ở mức vừa phải. Phương án này giảm việc nền tảng và giúp so sánh mô hình nhanh hơn. Các đánh đổi của nó là dữ liệu được xử lý bên ngoài, nhà cung cấp kiểm soát việc phát hành, giá theo mức sử dụng và giới hạn dịch vụ.
Hãy chọn hoặc thử nghiệm tự lưu trữ khi:
- Yêu cầu về nơi lưu trú dữ liệu hoặc chính sách nội bộ đòi hỏi kiểm soát hạ tầng chặt chẽ hơn.
- Việc cố định phiên bản mô hình là yếu tố trung tâm của khả năng kiểm toán.
- Nhu cầu sử dụng tác nhân đủ ổn định để năng lực tính toán chuyên dụng luôn được khai thác hiệu quả.
- Đội ngũ của bạn có thể đảm nhận việc đánh giá, bảo mật, ứng phó sự cố và vận hành GPU.
Hãy chọn hoặc thử nghiệm API khi tốc độ, tính linh hoạt và gánh nặng vận hành thấp quan trọng hơn. Đừng công bố tuyên bố về điểm hòa vốn cho đến khi bạn có giá theo khu vực, thông lượng mang tính đại diện và dữ liệu thực về kết quả được chấp nhận.
MLOps cho tác nhân AI không dừng lại ở endpoint
MLOps trong production cho tác nhân AI phải quản trị toàn bộ quy trình, không chỉ máy chủ mô hình. Tình trạng hoạt động của endpoint là cần thiết, nhưng không chứng minh được rằng tác nhân đã hoàn thành công việc hữu ích một cách an toàn.
Hãy quan sát độ trễ, lỗi, mức bão hòa, độ sâu hàng đợi, mức sử dụng GPU, số lần thử lại và năng lực tính toán. Sau đó, liên kết các tín hiệu đó với dữ liệu truy vết của tác nhân, lệnh gọi công cụ, các lần chuyển cấp cho con người và kết quả được chấp nhận. Cơ chế tự động co giãn nên phản ứng theo mô hình tải thực tế, không che giấu tình trạng quá tải phía sau những hàng đợi dài hơn.
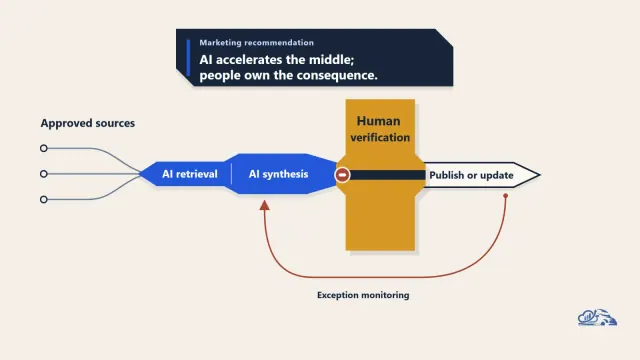
Đặt bước duyệt cho mọi thay đổi. Việc hoán đổi mô hình có thể làm thay đổi cách chọn công cụ, hành vi suy luận, đầu ra có cấu trúc hoặc kiểu từ chối. Thay đổi đối với vLLM, prompt, công cụ, cơ chế truy xuất hoặc dữ liệu nguồn cũng có thể gây ra điều tương tự. Hãy cố định phiên bản, chạy các bài đánh giá mang tính đại diện, phát hành theo từng giai đoạn, đặt ngưỡng hồi quy và duy trì một lộ trình hoàn tác đã được kiểm thử.
Áp dụng nguyên tắc đặc quyền tối thiểu ở cả hai ranh giới: từ tác nhân đến endpoint suy luận, rồi từ tác nhân đến từng công cụ nội bộ và nguồn dữ liệu. Tách biệt quyền đọc và quyền ghi. Ghi nhật ký các lệnh gọi công cụ có hệ quả lớn, bảo vệ thông tin xác thực và yêu cầu phê duyệt theo chính sách ở những nơi một hành động có thể ảnh hưởng đến khách hàng, tiền bạc hoặc hồ sơ.
Kỹ thuật dữ liệu là một phần của độ tin cậy tác nhân. Hãy theo dõi độ mới của feed và chỉ mục, dòng dõi dữ liệu (lineage), thay đổi schema, các bước kiểm tra chất lượng và kỳ vọng về mức dịch vụ. Mô hình không thể sửa một feed tài khoản mà nó chưa bao giờ nhận được, cũng không thể nhận ra một bản ghi lỗi thời nếu thiếu thông tin nguồn gốc.
Hãy xét một tác nhân RevOps minh họa. Tác nhân đọc dữ liệu tài khoản, đề xuất một hành động giữ chân khách hàng và cập nhật CRM. Một câu trả lời trôi chảy chưa phải là thành công. Kết quả chỉ được chấp nhận khi dữ liệu nguồn còn mới, đề xuất vượt qua kiểm tra chính sách, thao tác ghi thành công và có dấu vết kiểm toán.
Một đợt đánh giá quy trình miễn phí của Van Data Team có thể biến logic đó thành phạm vi triển khai. Bạn sẽ nhận được bản đồ khối lượng công việc, bản rà soát phân quyền, kế hoạch đánh giá, danh sách khoảng trống của dashboard và trình tự bàn giao. Tìm hiểu cách Van Data Team giúp hoạt động của tác nhân đo lường được.
Đo lường chi phí trên mỗi kết quả được chấp nhận
Chi phí trên mỗi kết quả được chấp nhận là cách công bằng nhất để so sánh một stack tác nhân tự lưu trữ với một stack dùng API. Tại Van Data Team, chúng tôi bắt đầu bằng việc định nghĩa "được chấp nhận" nghĩa là gì trước khi so sánh nhà cung cấp hay hạ tầng.
Với triển khai tự lưu trữ, hãy dùng:
Chi phí tự lưu trữ trên mỗi kết quả được chấp nhận = (năng lực GPU + dịch vụ cụm + lưu trữ và mạng + khả năng quan sát + nhân công nền tảng + chi phí thử lại và lượt chạy thất bại + rà soát của con người) / số kết quả được chấp nhận
Với dịch vụ được lưu trữ sẵn, hãy dùng:
Chi phí API được lưu trữ sẵn trên mỗi kết quả được chấp nhận = (mức sử dụng API + điều phối + dữ liệu và truy xuất + khả năng quan sát + chi phí thử lại và lượt chạy thất bại + rà soát của con người) / số kết quả được chấp nhận
Kết quả được chấp nhận là công việc kinh doanh đã hoàn thành và vượt qua các bước kiểm tra về chất lượng, chính sách và tính toàn vẹn dữ liệu. Với ví dụ RevOps, đó có thể là một đề xuất hợp lệ dựa trên dữ liệu tài khoản hiện hành, tiếp theo là một lần cập nhật CRM được ủy quyền.
Hãy chạy cả hai lộ trình trên cùng khối lượng công việc, khung thời gian, bước nghiệm thu và ranh giới chi phí. Bao gồm cả ngữ cảnh dài, vòng lặp công cụ, thử lại, lượt chạy thất bại, năng lực nhàn rỗi và việc chuyển cấp cho con người. Đo độ trễ và gánh nặng rà soát song song với chi phí, vì một kết quả rẻ hơn nhưng đến quá muộn có thể không còn giá trị.
Phân tách kết quả theo loại quy trình. Một tác nhân lập trình dài hơi, một tác nhân rà soát xử lý nhiều hình ảnh và một quy trình RevOps ngắn có thể sử dụng năng lực tính toán rất khác nhau. Một con số trung bình gộp có thể che giấu khối lượng công việc đang khiến tự lưu trữ trông rẻ hơn hoặc đắt hơn thực tế.
Sự tập trung vào kết quả này là lý do một tác nhân vượt trội hơn một danh sách kiểm tra. Tự động hóa xứng đáng với vị trí của nó khi liên tục tạo ra công việc có quản trị, chứ không phải khi chỉ tạo ra token rẻ.
Những kiểu thất bại thường gặp trước khi vận hành chính thức
Hầu hết các thất bại khi triển khai bắt đầu từ một sự nhầm lẫn về phạm trù hoặc một cơ chế kiểm soát vận hành bị thiếu. Hãy khắc phục những điểm sau trước khi mở endpoint cho các tác nhân trong production:
- Coi HyperPod là một tên gọi khác của EKS. HyperPod có thể dùng điều phối EKS, nhưng bổ sung thêm một lớp vận hành được quản lý.
- Gọi MXFP4 là engine phục vụ. vLLM phục vụ mô hình; MXFP4 mô tả định dạng trọng số.
- Cho rằng toàn bộ nhóm tham số đều hoạt động với mọi token. Suy luận MoE chỉ kích hoạt một phần nhỏ hơn.
- So sánh giá token mà bỏ qua năng lực nhàn rỗi, thử lại, lỗi, nhân công và rà soát của con người.
- Hoán đổi mô hình, prompt, công cụ hoặc nguồn dữ liệu mà không có đánh giá hồi quy và phương án hoàn tác.
- Cấp quyền truy cập rộng cho tác nhân chỉ vì endpoint nằm trong một mạng được tin cậy.
- Giám sát thời gian hoạt động của máy chủ mà bỏ qua lỗi công cụ, lỗi tuân thủ chính sách và chất lượng kết quả.
- Phục vụ trọng số mới trên nền dữ liệu kinh doanh lỗi thời, chất lượng thấp hoặc không truy được nguồn gốc.
- Tuyên bố tiết kiệm chi phí khi chưa có giá AWS hiện hành, hóa đơn API, tình trạng sẵn có của năng lực tính toán và benchmark khối lượng công việc.
Cách Van Data Team đưa giải pháp vào vận hành thực tế
Tại Van Data Team, chúng tôi tiếp cận Kimi K3 trên AWS như một quy trình vận hành, không phải một thử nghiệm hạ tầng. Trước tiên, chúng tôi lập bản đồ cách một yêu cầu của tác nhân di chuyển từ dữ liệu nguồn qua điều phối, suy luận, lệnh gọi công cụ, rà soát đến hành động cuối cùng. Bản đồ đó xác định người phụ trách, các điểm ra quyết định, trạng thái lỗi và lộ trình khôi phục.
Đầu ra hữu ích là một kế hoạch bàn giao có phạm vi rõ ràng:
- Các tín hiệu cần thu thập về độ trễ, năng lực tính toán, việc sử dụng công cụ, độ mới của dữ liệu, lỗi và kết quả được chấp nhận
- Các khoảng trống quy trình cần bổ sung cơ chế thử lại, phương án dự phòng, phân quyền hoặc quyền sở hữu rõ ràng hơn
- Các hành động có tác động lớn cần con người rà soát trước khi thực thi
- Các bước đánh giá và kiểm tra hồi quy cho những thay đổi về mô hình, prompt, công cụ hoặc dữ liệu
- Dashboard và runbook cho người vận hành biết điều gì đã xảy ra và cần làm gì tiếp theo
Cách tiếp cận này kết nối lớp phục vụ mô hình với hoạt động kinh doanh. HyperPod hoặc EKS có thể giữ cho endpoint luôn sẵn sàng, nhưng chỉ riêng tính sẵn sàng không làm cho tác nhân trở nên đáng tin cậy. Các đội ngũ còn cần quyền truy cập đặc quyền tối thiểu, đầu vào truy được nguồn gốc, các điểm kiểm tra rà soát và một lộ trình đã được kiểm thử để quay lại sau các hành động thất bại. Kết quả là một hệ thống production được đo bằng kết quả được chấp nhận, chứ không chỉ bằng số token được phục vụ hay mức sử dụng GPU.
Ngân sách vận hành
Trước khi triển khai lên production, hãy so sánh Kimi K3 trên AWS với API được lưu trữ sẵn của Kimi K3 và các API tiên phong khác. Dùng cùng các tác vụ tác nhân tiêu biểu và cùng tiêu chí nghiệm thu. Đơn giá token của nhà cung cấp chỉ là một đầu vào. Chúng không bao gồm năng lực GPU nhàn rỗi, lượt chạy thất bại, lệnh gọi công cụ lặp lại, thời gian của người rà soát và công việc khôi phục.
Chi phí trên mỗi kết quả quy trình được phê duyệt = (tính toán + phục vụ mô hình + lưu trữ và mạng + nhân công nền tảng + nhân công rà soát + chi phí thử lại và khôi phục) ÷ số kết quả được phê duyệt.
Với mỗi ứng viên, hãy ghi lại chi phí trên mỗi đầu ra được chấp nhận, độ trễ trung vị và độ trễ đuôi, lượng token sử dụng, tỷ lệ thử lại, số phút rà soát và công sức khôi phục sau lỗi. Bổ sung kết quả đánh giá về chất lượng tác vụ, cách dùng công cụ, khả năng bám nguồn (grounding), an toàn và mức hồi quy so với mô hình production hiện tại.
Hãy chạy bảng điểm trên các quy trình RevOps hoàn chỉnh, không phải trên các prompt riêng lẻ. Một phản hồi nhanh và rẻ có ít giá trị nếu tác nhân cần nhiều lần thử lại hoặc cần con người sửa.
Node Kimi K3 tám GPU được khuyến nghị là năng lực chuyên dụng tốn kém. Nó có nhiều khả năng hoàn vốn nhất khi lưu lượng lớn, duy trì liên tục và mức sử dụng cao. API vẫn có thể rẻ hơn với nhu cầu không đều. Tự lưu trữ xứng đáng với vị trí của nó khi lợi ích từ chi phí thấp hơn trên mỗi kết quả được chấp nhận, khả năng quản trị và kiểm soát mô hình lớn hơn gánh nặng MLOps tăng thêm.
Công cụ và vị trí trong hệ sinh thái
Kimi K3 trên AWS phù hợp với các đội ngũ có nhu cầu tác nhân ổn định, yêu cầu kiểm soát dữ liệu nghiêm ngặt và nhân sự có khả năng vận hành các cụm GPU lớn. API được lưu trữ sẵn vẫn phù hợp hơn với lưu lượng tăng đột biến, các dự án thí điểm nhanh và những đội ngũ không muốn gánh rủi ro về năng lực tính toán.
Hãy chọn SageMaker HyperPod khi khả năng phục hồi được quản lý, tự động co giãn, khả năng quan sát và công cụ quản lý cụm quan trọng hơn nhu cầu kiểm soát ở cấp thấp. Hãy chọn Amazon EKS thuần khi một đội ngũ nền tảng giàu kinh nghiệm đã quản lý Kubernetes và muốn trực tiếp nắm quyền lên lịch, mạng, bảo mật và nâng cấp.
Những lựa chọn hạ tầng này không thay thế việc điều phối tác nhân. Các framework như LangGraph điều phối trạng thái quy trình, lệnh gọi công cụ, thử lại và rà soát của con người. vLLM phục vụ mô hình, còn MXFP4 mô tả định dạng trọng số. Mỗi lớp giải quyết một vấn đề khác nhau.
Mức độ phù hợp cho production còn phụ thuộc vào các cơ chế kiểm soát khi vận hành. Việc hoán đổi mô hình cần bộ bài đánh giá và bước kiểm tra hồi quy. Tác nhân cần lệnh gọi công cụ truy vết được, quyền truy cập đặc quyền tối thiểu và lộ trình chuyển cấp cho các hành động có hệ quả lớn. Nguồn dữ liệu của tác nhân cần feed còn mới, chỉ mục đáng tin cậy, dòng dõi dữ liệu, phân quyền và mục tiêu mức dịch vụ rõ ràng. Thiếu những nền tảng đó, một mô hình tiên phong có thể thực thi sai quy trình nhanh hơn.
Câu hỏi thường gặp
AWS đã phát hành gì cho Kimi K3 trên AWS?
AWS đã công bố một hướng dẫn triển khai production cho SageMaker HyperPod và Amazon EKS. Hướng dẫn nêu rõ hạ tầng GPU được khuyến nghị, cách phục vụ bằng vLLM, trọng số MXFP4, các lựa chọn năng lực tính toán, cách thiết lập endpoint và quy trình xác thực. Hướng dẫn giúp việc triển khai trở nên cụ thể; nó không quyết định việc tự lưu trữ có phù hợp với bài toán kinh tế hay nhu cầu quản trị của bạn hay không.
SageMaker HyperPod có giống Amazon EKS không?
Không. SageMaker HyperPod hỗ trợ điều phối EKS bên cạnh Slurm, nhưng bổ sung công cụ quản lý cụm GPU, khả năng phục hồi, co giãn và quan sát được quản lý. Một triển khai EKS thuần để lại nhiều phần vận hành Kubernetes, năng lực tính toán và suy luận hơn cho đội ngũ của bạn. Cả hai lộ trình vẫn đòi hỏi quản trị mô hình, bảo mật, đánh giá và kiểm soát dữ liệu.
Vì sao AWS khuyến nghị vLLM và MXFP4?
vLLM là engine phục vụ, còn MXFP4 là định dạng lượng tử hóa mà Kimi K3 dùng khi phát hành. AWS khuyến nghị sự kết hợp này vì vLLM hỗ trợ kiến trúc MoE, song song tensor và định dạng trọng số đó. Tách bạch hai vai trò này giúp các đội ngũ phân công đúng trách nhiệm cho việc phục vụ mô hình, artifact của mô hình và nâng cấp.
Khi nào tự lưu trữ vượt trội hơn việc dùng API được lưu trữ sẵn?
Tự lưu trữ trở nên hấp dẫn khi nhu cầu kiểm soát dữ liệu trong VPC, kiểm soát phiên bản mô hình, mức sử dụng ổn định hoặc yêu cầu quản trị đủ để biện minh cho năng lực tính toán chuyên dụng và công việc vận hành nền tảng. API được lưu trữ sẵn vẫn hấp dẫn với nhu cầu biến động và khi cần thử nghiệm nhanh hơn. Hãy so sánh cả hai với cùng khối lượng công việc, bước nghiệm thu và ranh giới chi phí trước khi lựa chọn.
Các đội ngũ nên đo lường gì trước khi đưa tác nhân AI vào production?
Theo dõi độ trễ endpoint, lỗi, độ sâu hàng đợi, mức bão hòa, mức sử dụng GPU, số lần thử lại, lỗi công cụ, các lần chuyển cấp cho con người và tỷ lệ kết quả được chấp nhận. Đồng thời giám sát hồi quy trong đánh giá, độ mới của dữ liệu, dòng dõi dữ liệu, lỗi phân quyền và sự kiện bảo mật. Chỉ nhìn vào chi phí token sẽ bỏ sót những công việc thất bại, đến muộn hoặc cần sửa thủ công.
Các đội ngũ nên quản lý việc cập nhật mô hình Kimi K3 như thế nào?
Cố định phiên bản mô hình đang chạy production và đánh giá mọi ứng viên trên các tác vụ và chính sách mang tính đại diện. Triển khai theo từng giai đoạn, theo dõi cả tín hiệu hạ tầng lẫn tín hiệu kết quả, và duy trì một lộ trình hoàn tác đã được kiểm thử. Kiểm thử lại prompt, quyền dùng công cụ, hành vi truy xuất và đầu ra có cấu trúc, vì một thay đổi mô hình có thể làm thay đổi toàn bộ quy trình tác nhân.