Suy luận 4-bit có ý nghĩa gì với chi phí AI cho marketing
Suy luận 4-bit NVFP4 trên GPU Blackwell giảm khoảng một nửa phần cứng để chạy mô hình. Mức giảm chi phí cấu trúc này nghĩa là gì với đội marketing và tác nhân.
Tổng quan
Hầu hết các đội ngũ tiếp thị không bao giờ trực tiếp nhìn thấy các bộ vi xử lý đồ họa (GPU) mà hệ thống AI của họ đang chạy trên đó, nhưng họ phải chi trả cho phần cứng đó qua từng token dữ liệu. Câu chuyện thầm lặng của năm 2026 là chi phí của mỗi token đó đang giảm mạnh ngay từ cấp độ phần cứng, và công nghệ suy luận 4-bit (4-bit inference) chính là nguyên nhân. Định dạng NVFP4 của NVIDIA chạy trên các GPU kiến trúc Blackwell cho phép một mô hình chiếm ít bộ nhớ hơn và đòi hỏi ít chip xử lý hơn đáng kể, giúp hạ thấp chi phí đơn vị của mọi tính năng AI mà doanh nghiệp triển khai.
Bài viết này giải thích bản chất của suy luận 4-bit, mức độ cắt giảm chi phí thực tế trong sản xuất và những hành động mà một đội ngũ tiếp thị hoặc nội dung nên thực hiện. Các dữ kiện công nghệ được trích dẫn từ NVIDIA và các bài kiểm tra đánh giá độc lập; những hàm ý tiếp thị là phân tích của Vanaxity, được trình bày như khuyến nghị chứ không phải điều chắc chắn. Nội dung kế thừa từ các phân tích của chúng tôi về FinOps cho các tác nhân AI và ROI của tác nhân AI.
Những điểm cốt lõi cần nhớ
- Suy luận 4-bit vận hành các mô hình theo định dạng NVFP4 của NVIDIA, sử dụng 4 bit cho mỗi giá trị thay vì 8 hoặc 16 bit, và chạy nguyên bản trên các GPU Blackwell như B200 và B300.
- NVFP4 giúp thu nhỏ dung lượng bộ nhớ của mô hình khoảng 3,5 lần so với định dạng 16-bit và 1,8 lần so với 8-bit, do đó một mô hình 70B từng cần hai chip H100 ở chuẩn FP8 nay có thể nằm gọn trên một chip B200 duy nhất.
- Sự suy giảm về chất lượng là rất nhỏ: NVIDIA công bố mức giảm độ chính xác chỉ 1% hoặc thấp hơn so với FP8 trên mô hình DeepSeek-R1, và thậm chí đạt điểm số cao hơn một chút trên một bài kiểm tra chuẩn đối sánh toán học.
- Đối với các đội ngũ tiếp thị, đây là sự cắt giảm mang tính cấu trúc đối với chi phí suy luận chứ không phải một đợt nâng cấp mô hình, và nó chủ yếu đến với bạn qua mức giá dịch vụ rẻ hơn từ các nhà cung cấp đám mây thay vì tự mua phần cứng.
- Khuyến nghị từ Vanaxity: Coi suy luận 4-bit như một khoản chiết khấu cần chủ động thu hồi, ưu tiên các nhà cung cấp chuyển giao phần tiết kiệm này cho khách hàng và tự kiểm chứng chất lượng trên các tác vụ thực tế trước khi chuyển đổi.
Xác định quy trình SEO, GEO và AEO phù hợp trước khi triển khai.
Suy luận 4-Bit là gì và vì sao công nghệ này bùng nổ vào lúc này?
Suy luận 4-bit là việc vận hành một mô hình AI với mỗi con số tham số được lưu trữ chỉ trong 4 bit, thay vì 16 hoặc 8 bit như trước đây. Ít bit hơn trên mỗi số đồng nghĩa với việc tiêu tốn ít dung lượng bộ nhớ hơn và cần ít băng thông hơn để luân chuyển mô hình, vốn là nơi phần lớn chi phí suy luận ẩn giấu. Lý do công nghệ này trở nên quan trọng ở thời điểm hiện tại là vì phần cứng thế hệ mới cuối cùng đã thực thi các phép toán 4-bit một cách nguyên bản ở cấp độ mạch bán dẫn, giúp việc tiết kiệm chi phí là có thật chứ không phải một thủ thuật phần mềm làm suy hao dữ liệu.
**Dữ liệu thực tế:** Định dạng NVFP4 của NVIDIA sử dụng 4 bit cho mỗi giá trị, với một hệ số tỷ lệ dùng chung cho mỗi khối 16 giá trị để bảo toàn độ chính xác. Nó vận hành trực tiếp trên các GPU Blackwell và Blackwell Ultra sở hữu nhân Tensor Core FP4 nguyên bản, và được hỗ trợ hoàn toàn trong ngăn xếp dịch vụ TensorRT-LLM của NVIDIA, hiện ở phiên bản 1.2. Định kiến trước đây cho rằng 4-bit làm mất mát quá nhiều dữ liệu để có thể đưa vào sản xuất nay đã thay đổi: định dạng dữ liệu và chip bán dẫn đã được đồng thiết kế để bảo toàn chất lượng trong khi cắt giảm tối đa số bit.
Ba yếu tố then chốt đã đồng thời hội tụ để 4-bit trở thành một giải pháp sản xuất thực tế thay vì một thử nghiệm trong phòng nghiên cứu, và năm 2026 chính là thời điểm chín muồi:
- Phần cứng chuyên dụng nguyên bản: Các nhân Tensor Core của kiến trúc Blackwell thực thi trực tiếp các phép tính FP4 thay vì phải giả lập qua phần mềm, giúp việc tăng tốc độ diễn ra thực chất.
- Định dạng thông minh hơn: Cơ chế tỷ lệ trên từng khối của NVFP4 giúp bảo toàn độ chính xác gần như tương đương chuẩn 8-bit, vượt trội so với các phương pháp nén 4-bit thô sơ trước đây.
- Phần mềm phục vụ mô hình hoàn thiện: NVFP4 hiện là thành phần cốt lõi trong TensorRT-LLM và các giao diện lập trình phục vụ mô hình, giúp các đội ngũ có thể triển khai mà không cần tự lập trình các nhân xử lý cấp thấp.
**Phân tích của Vanaxity:** Bạn không cần phải là chuyên gia về nhân Tensor Core để hiểu được giá trị của bước tiến này. Điểm cốt lõi là ngành công nghiệp vừa giúp việc vận hành cùng một mô hình trở nên rẻ hơn rất nhiều, và mức chiết khấu đó sẽ chảy thẳng đến bất kỳ ai mua dịch vụ AI theo đơn vị token. Những đội ngũ hiểu rõ vì sao hóa đơn của họ đang giảm sẽ biết cách đàm phán và định tuyến thông minh để thu hồi lợi ích, thay vì bỏ qua cơ hội trên bàn đàm phán.
Suy luận 4-Bit giúp cắt giảm chi phí AI ở mức độ nào?
Đủ lớn để thay đổi trực tiếp số lượng GPU cần thiết cho một khối lượng công việc, vốn là biến số quyết định toàn bộ giá thành dịch vụ. Cách dễ nhất để thấy rõ điều này là nhìn vào dung lượng bộ nhớ chiếm dụng, vì nó quyết định một con chip có thể chứa được bao nhiêu phần của mô hình.
| Độ chính xác | Số bit trên mỗi giá trị | Dung lượng bộ nhớ so với FP16 | Môi trường thực thi |
|---|---|---|---|
| FP16 / BF16 | 16 | Mức chuẩn cơ sở | Hầu hết các dòng GPU |
| FP8 | 8 | ~2x nhỏ hơn | Hopper, Blackwell |
| NVFP4 (4-bit) | 4 | ~3.5x nhỏ hơn | Blackwell (FP4 nguyên bản) |
**Dữ liệu thực tế:** NVIDIA công bố NVFP4 giúp cắt giảm dung lượng bộ nhớ của mô hình khoảng 3,5 lần so với FP16 và khoảng 1,8 lần so với FP8. Trên thực tế, mật độ đó đồng nghĩa với việc một chip B200 đơn lẻ chạy NVFP4 có thể phục vụ mô hình 70B mà trước đây đòi hỏi hai chip H100 chạy ở chuẩn FP8, trong khi vẫn còn dư bộ nhớ cho bộ đệm ngữ cảnh lớn hơn. NVIDIA cũng trích dẫn mức cải thiện hiệu quả năng lượng trên mỗi token từ 25 đến 50 lần trên Blackwell và Blackwell Ultra so với mức chuẩn cơ sở của H100.
**Phân tích của Vanaxity:** Hãy quy đổi điều đó thành con số cụ thể trên hóa đơn. Việc giảm một nửa số lượng GPU cần thiết để phục vụ một mô hình sẽ cắt giảm khoảng một nửa chi phí phần cứng đằng sau năng lực suy luận của bạn, và chi phí điện năng tiêu thụ chiếm phần lớn phần còn lại. Bạn hiếm khi thấy một nút bật tắt có nhãn '4-bit' trên bảng điều khiển quản trị; bạn sẽ thấy điều đó qua sự sụt giảm giá trên mỗi token từ các nhà cung cấp đã chuyển sang hạ tầng Blackwell. Đối với một đội ngũ đang vận hành sản xuất nội dung quy mô lớn, truy xuất dữ liệu và hệ thống tác nhân AI, đó là sự khác biệt giữa một tính năng AI sinh lời và một tính năng thua lỗ, cùng một bài toán tài chính mà chúng tôi mổ xẻ trong FinOps cho các tác nhân AI.
Dưới đây là một ví dụ minh họa trực quan, sử dụng các con số ước tính tròn trịa thay vì biểu phí cụ thể của một nhà cung cấp nào. Giả sử bạn sử dụng 200 triệu token mỗi tháng qua một mô hình có giá 6,00 USD trên mỗi triệu token trên phần cứng 8-bit, tương đương 1.200 USD mỗi tháng. Nếu việc chuyển sang 4-bit trên chip Blackwell cho phép nhà cung cấp vận hành cùng mô hình đó trên một nửa số lượng chip và họ chuyển giao dù chỉ một phần mức tiết kiệm đó cho khách hàng, mức giá giảm xuống khoảng 4,00 USD trên mỗi triệu token sẽ đưa chi phí cho cùng khối lượng công việc xuống còn khoảng 800 USD. Đó là mức cắt giảm 400 USD mỗi tháng, tương đương khoảng 33%, mà không làm thay đổi bất kỳ tính năng sản phẩm nào của bạn. Các con số thực tế có thể khác nhau, nhưng xu hướng là hoàn toàn rõ ràng: mức chiết khấu này mang tính cấu trúc và sẽ nhân lên theo quy mô sản lượng.
Ngoài ra còn có một lợi ích thứ hai có ý nghĩa đặc biệt quan trọng đối với các khối lượng công việc tiếp thị. Dung lượng bộ nhớ mà 4-bit giải phóng không nhất thiết chỉ dùng để giảm bớt số lượng GPU; nó có thể được chuyển hóa thành cửa sổ ngữ cảnh rộng hơn. Không gian giải phóng cho phép nhà cung cấp duy trì bộ nhớ đệm khóa-giá trị (key-value cache) lớn hơn, đồng nghĩa với các câu lệnh dài hơn, cửa sổ truy xuất dữ liệu rộng lớn hơn và nhiều yêu cầu đồng thời hơn trên cùng một con chip. Đối với quy trình RAG trên toàn bộ thư viện nội dung của doanh nghiệp hoặc các tác nhân AI cần duy trì lịch sử hội thoại dài, khoảng không gian bổ sung đó có giá trị ngang với việc giảm giá, vì nó chính là rào cản thường buộc bạn phải nâng cấp lên các gói dịch vụ đắt đỏ hơn.
Suy luận 4-Bit có làm suy giảm chất lượng đầu ra không?
Mức độ suy giảm ít hơn nhiều so với bạn nghĩ, nhưng không phải bằng không, và câu trả lời trung thực nhất là bạn phải tự đo lường. Toàn bộ mục tiêu phát triển NVFP4 là làm cho định dạng 4-bit đủ chính xác cho môi trường sản xuất thực tế, chứ không chỉ đơn thuần là chạy nhanh hơn.
**Dữ liệu thực tế:** Trên các bài kiểm tra chuẩn đối sánh của NVIDIA, NVFP4 ghi nhận mức suy giảm độ chính xác chỉ 1% hoặc thấp hơn so với chuẩn FP8 trên mô hình DeepSeek-R1, và trên bài kiểm tra toán học chuẩn AIME 2024 nó thậm chí đạt điểm số cao hơn khoảng 2%. Đó là khoảng cách chất lượng nhỏ hơn rất nhiều so với các phương pháp 4-bit đời cũ, giải thích vì sao nó đủ tiêu chuẩn áp dụng cho các khối lượng công việc thực tế chứ không chỉ dừng lại ở các bài trình diễn demo. Đây là các số liệu do chính NVIDIA công bố, vì vậy hãy coi đó là tín hiệu định hướng mạnh mẽ thay vì một sự bảo đảm tuyệt đối cho các tác vụ cụ thể của bạn.
**Phân tích của Vanaxity:** Mức chênh lệch 1% trên các bài kiểm tra đối sánh tổng hợp không đồng nghĩa với việc không có sự khác biệt trên nội dung thực tế của bạn. Quá trình lượng tử hóa thường bộc lộ điểm yếu rõ nhất ở các vùng biên giới hạn: những đoạn văn bản đầu ra rất dài, các định dạng tài liệu hiếm gặp, và các nhiệm vụ đòi hỏi khả năng truy xuất dữ kiện tuyệt đối chính xác, vốn là những nơi mà công việc tiếp thị đôi khi phải đối mặt. Do đó, đừng mặc định 4-bit là hoàn toàn miễn phí về mặt chất lượng; hãy giả định nó là một giải pháp giá rẻ cần được kiểm chứng. Hãy chạy thử các câu lệnh thực tế của bạn ở cả hai chuẩn 4-bit và 8-bit, so sánh các kết quả đầu ra được chấp nhận, và để chi phí trên mỗi kết quả đạt chuẩn quyết định sự lựa chọn, chứ không phải con số độ chính xác ghi trên nhãn mác.
Các đội ngũ tiếp thị nên làm gì trước làn sóng suy luận 4-Bit?
Hãy chủ động nắm bắt mức chiết khấu này mà không phải chi trả quá mức cho quyền kiểm soát hạ tầng mà bạn không thực sự cần. Đối với hầu hết các đội ngũ, suy luận 4-bit là lý do để khảo sát và đàm phán lại giá dịch vụ, chứ không phải lý do để đi mua sắm phần cứng máy chủ.
- Chủ động hỏi các nhà cung cấp về độ chính xác mà họ đang phục vụ. Nếu họ đã chuyển đổi sang phần cứng Blackwell và chuẩn NVFP4, giá trên mỗi token của bạn phải phản ánh sự suy giảm chi phí này, hãy sử dụng dữ kiện đó làm đòn bẩy khi gia hạn hợp đồng.
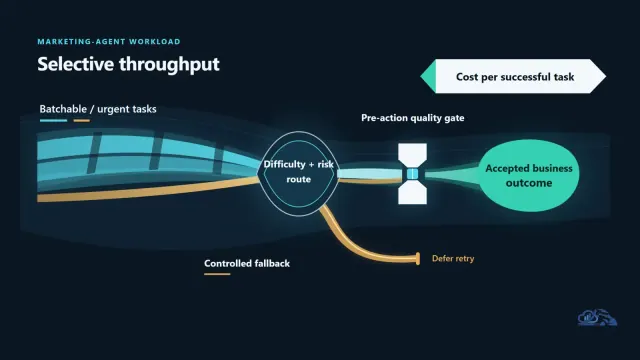
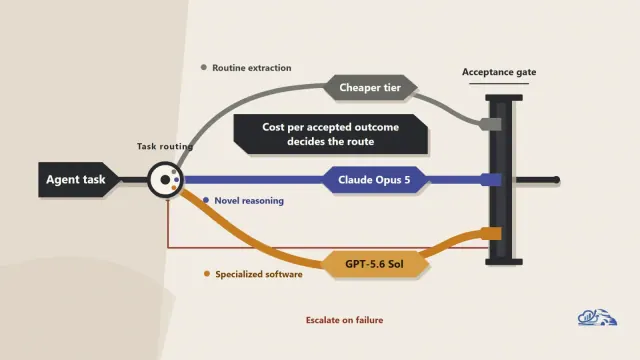
- Định tuyến các công việc số lượng lớn, nhạy cảm về chi phí đến các điểm cuối dịch vụ rẻ nhất vượt qua được ngưỡng chất lượng của bạn, vì 4-bit giúp nhiều nhà cung cấp giá rẻ đạt chuẩn chất lượng chấp nhận được.
- Chỉ tự vận hành máy chủ riêng (self-host) nếu doanh nghiệp của bạn vốn đã sở hữu cụm GPU riêng. Trên phần cứng Blackwell, TensorRT-LLM hỗ trợ phục vụ NVFP4 trực tiếp, kết hợp rất tốt với các mô hình mã nguồn mở như chúng tôi phân tích trong AI trọng số mở cho tiếp thị.
- Luôn kiểm tra đối sánh chất lượng ở chuẩn 4-bit trên chính các tác vụ của bạn trước khi chuyển đổi toàn bộ khối lượng công việc sản xuất thực tế, không chỉ dựa vào số liệu của nhà cung cấp.
- Theo dõi chi phí trên mỗi kết quả đầu ra được chấp thuận, không đo chi phí trên mỗi token, để một mức giá rẻ hơn nhưng đòi hỏi phải tạo lại nhiều lần không đánh lừa bạn bằng khoản tiết kiệm ảo.
**Phân tích của Vanaxity:** Sai lầm lớn nhất là coi đây là một chủ đề hạ tầng kỹ thuật mà bạn có thể phớt lờ vì bạn không trực tiếp quản lý GPU. Đây là một câu chuyện về định giá dịch vụ, và bài toán chi phí là trách nhiệm của tất cả mọi người. Các đội ngũ tận dụng được cổ tức từ công nghệ 4-bit là những người biết đặt đúng câu hỏi vào thời điểm gia hạn và biết định tuyến yêu cầu dựa trên chi phí đo lường được, chứ không phải những bên tình cờ sở hữu những con chip nhanh nhất. Để tìm hiểu sâu hơn về bài toán chi phí, bạn có thể tham khảo cách chúng tôi phân tích hiệu quả kinh tế của lượng tử hóa FP4 trên GPU Blackwell đối với khối lượng công việc thực tế.
Cách Vanaxity giúp biến các khoản tiết kiệm từ 4-Bit thành ngân sách thực tế
Vanaxity giúp các đội ngũ tiếp thị biến chi phí suy luận ngày càng giảm thành một hóa đơn AI nhỏ gọn hơn và dễ bảo vệ hơn trước ban lãnh đạo. Chúng tôi bắt đầu bằng việc lập bản đồ chi tiêu thực tế của bạn: những khối lượng công việc nào tiêu tốn nhiều token, những khâu nào bị giới hạn bởi độ trễ, và những phần việc nào có thể chuyển sang mức độ chính xác tiết kiệm hơn mà không làm tổn hại đến chất lượng.
Sau đó, chúng tôi thử nghiệm các tác vụ thực tế của bạn trên nhiều mức độ chính xác và nhiều nhà cung cấp khác nhau, tính toán chi phí trên mỗi kết quả đầu ra được chấp thuận, và định tuyến từng tác vụ đến điểm cuối rẻ nhất vượt qua được ngưỡng chất lượng đã định. Chúng tôi cũng định kỳ rà soát lại sự phân bổ này theo lịch trình, vì khả năng hỗ trợ độ chính xác và biểu phí của các nhà cung cấp thay đổi rất nhanh, và một khoản tiết kiệm bạn đạt được trong quý trước có thể mở rộng hoặc thu hẹp vào quý tiếp theo. Nếu bạn cần sự đồng hành, các dịch vụ của chúng tôi có thể xây dựng kế hoạch định tuyến mô hình và độ chính xác tối ưu cho các luồng công việc nội dung và tác nhân của bạn, đồng thời bạn có thể khám phá thêm các ghi chú thực tế trong thư viện bài viết. Mục tiêu rất đơn giản: chi trả mức giá của năm 2026 cho AI, chứ không phải mức giá đắt đỏ của năm ngoái.
Câu hỏi thường gặp
Suy luận 4-bit là gì?
Suy luận 4-bit là việc vận hành mô hình AI với mỗi con số tham số được lưu trữ chỉ trong 4 bit thay vì 16 hoặc 8 bit như trước đây, giúp giảm mạnh dung lượng bộ nhớ và băng thông cần thiết để phục vụ mô hình. Phiên bản của NVIDIA mang tên NVFP4 và chạy nguyên bản trên các dòng GPU Blackwell như B200. Ít bit hơn trên mỗi giá trị đồng nghĩa với việc nhiều phần của mô hình hơn có thể nằm vừa trên một con chip duy nhất, do đó cần ít GPU hơn và tiêu thụ ít năng lượng hơn để phục vụ cùng một khối lượng công việc, chính điều này giúp hạ thấp chi phí.
Suy luận 4-bit giúp tiết kiệm chi phí ở mức nào?
NVIDIA cho biết NVFP4 giúp thu nhỏ dung lượng bộ nhớ của mô hình khoảng 3,5 lần so với chuẩn 16-bit và khoảng 1,8 lần so với 8-bit. Trên thực tế, một mô hình 70B từng cần hai chip H100 ở chuẩn FP8 nay có thể chạy trên một chip B200 đơn lẻ ở chuẩn NVFP4, giúp giảm khoảng một nửa phần cứng đằng sau khối lượng công việc đó, kèm theo hiệu quả năng lượng trên mỗi token vượt trội của kiến trúc Blackwell. Đối với người mua dịch vụ, điều đó thể hiện qua mức giá trên mỗi token rẻ hơn từ các nhà cung cấp đám mây đã ứng dụng công nghệ này, thay vì một mục phí riêng biệt mang tên 4-bit.
Suy luận 4-bit có làm giảm chất lượng đầu ra không?
Mức độ suy giảm chỉ rất nhỏ theo các bài kiểm tra chuẩn đối sánh của NVIDIA, với độ chính xác chỉ giảm 1% hoặc thấp hơn so với chuẩn FP8 trên mô hình DeepSeek-R1, và thậm chí đạt mức tăng nhẹ trên một bài kiểm tra toán học. Kết quả này vượt trội hơn rất nhiều so với các phương pháp 4-bit đời cũ, giải thích vì sao nó có thể đưa vào môi trường sản xuất thực tế. Tuy nhiên, đó là số liệu của nhà cung cấp trên các tác vụ mẫu, vì vậy bạn nên tự kiểm chứng trên chính khối lượng công việc của mình, vì quá trình lượng tử hóa có thể ảnh hưởng nặng nề hơn ở những văn bản đầu ra dài, các định dạng hiếm hoặc tác vụ cần truy xuất dữ kiện tuyệt đối chính xác.
Tôi có cần phải mua GPU Blackwell để được hưởng lợi không?
Hoàn toàn không đối với hầu hết các đội ngũ. Nếu bạn sử dụng các giao diện lập trình (API) AI được lưu trữ trên đám mây, bạn sẽ tự động hưởng lợi khi nhà cung cấp phục vụ mô hình trên phần cứng Blackwell với chuẩn NVFP4 qua mức giá trên mỗi token thấp hơn, vì vậy hành động cần làm là chủ động hỏi về chuẩn độ chính xác mà họ đang chạy và tận dụng điều đó khi đàm phán hợp đồng. Chỉ những đội ngũ vốn đã tự vận hành cụm GPU riêng mới cần tính toán mua sắm phần cứng, và đối với họ TensorRT-LLM hỗ trợ NVFP4 trực tiếp trên kiến trúc Blackwell.
Các đội ngũ tiếp thị nên hành động như thế nào trước công nghệ suy luận 4-bit?
Hãy coi đây là một cơ hội về giá cả, chứ không phải một dự án hạ tầng kỹ thuật. Chủ động hỏi các nhà cung cấp về chuẩn độ chính xác mà họ phục vụ, định tuyến các tác vụ số lượng lớn đến điểm cuối rẻ nhất vượt qua được ngưỡng chất lượng của bạn, và luôn tự kiểm tra đối sánh chất lượng ở chuẩn 4-bit trên chính công việc thực tế trước khi chuyển đổi toàn bộ quy trình sản xuất. Hãy đo lường chi phí trên mỗi kết quả đầu ra được chấp thuận thay vì chi phí trên mỗi token, để mức giá rẻ hơn nhưng phải chạy lại nhiều lần không tạo ra sự tiết kiệm ảo.